Incident Response: SANS 6 fases, NIST SP 800-61, playbooks prácticos
· 6 min de lectura
Cómo se gestiona un incidente de seguridad: preparación, identificación, contención, erradicación, recuperación, lessons learned. Framework SANS/NIST, roles del equipo IR y plantilla de playbook.
Incident Response (IR) es la disciplina de gestionar un incidente de seguridad desde la primera alerta hasta el cierre formal, limitando daño y aprendiendo del evento. Un equipo IR maduro combina procesos documentados, tooling preparado, gente entrenada y comunicación efectiva con ejecutivos, legal, clientes y, cuando corresponde, prensa y reguladores. En 2026 es una capacidad crítica: cada empresa grande y muchas medianas tienen equipo IR interno; las pequeñas contratan vendors (Mandiant, CrowdStrike Services, Unit 42) bajo retainer para respuesta rápida.
Esta lección es la última de la Tanda 5 y cierra el bloque de defensa avanzada. Cubre el framework canónico SANS/NIST de 6 fases (que casi todas las organizaciones adoptan como base), roles típicos del equipo IR, estructura de playbooks prácticos, herramientas estándar, y las lecciones prácticas de incidentes reales. Es la pieza que cose todas las lecciones defensivas anteriores (logs, Volatility, forense, hunting, ransomware) en un workflow operacional.
IR es defensivo puro, applicable a tu propia organización. Trabajo real requiere autorización explícita del CISO/CIO.
Las 6 fases SANS#
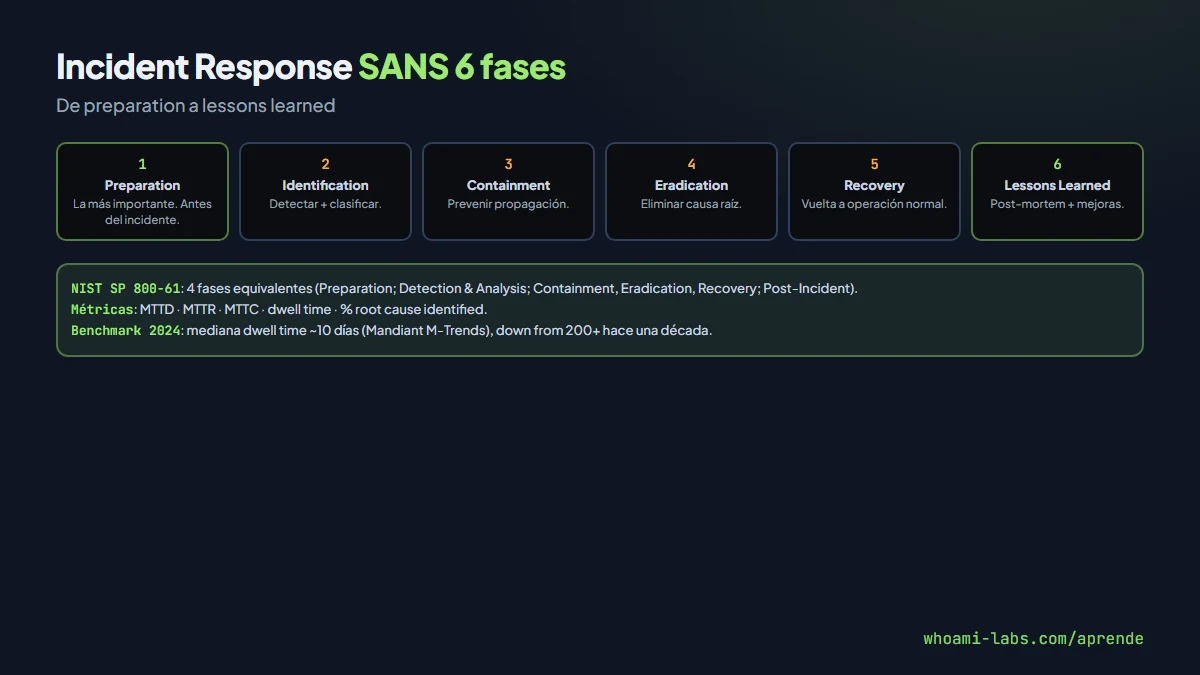
Preparation#
Antes del incidente. La fase más importante porque determina el éxito de todas las demás.
- Documentación: policies, playbooks, contact lists, authorization letters.
- Tooling: EDR, SIEM, forense tools, secure out-of-band comms.
- Training: equipo entrenado en runbooks + tabletops regulares.
- Relationships: vendor IR retainer, legal counsel, cyber insurance.
- Baseline: inventario de assets, normal behavior documentado.
Sin preparation, las demás fases son caóticas. Con preparation, se ejecutan sistemáticamente.
Identification#
Detectar que hay un incidente. Fuentes:
- Alerta SIEM/EDR.
- Hunting proactivo.
- Reporte de usuario.
- Vendor notification (p. ej. breach de SaaS).
- Threat intel feed.
- Ley de orden avisando.
Criterios para elevar: ¿confirmado? ¿scope? ¿severidad inicial? Classification: Incident, Event, False Positive.
Containment#
Prevenir que el incidente se propague más. Dos sub-fases:
- Short-term containment: aislar máquinas afectadas (network isolation, cuentas deshabilitadas) sin apagar (preserva forense).
- Long-term containment: después de forense, aplicar fixes temporales (block IPs en firewall, revoke credentials).
Balancear: contener rápido vs preserve evidence.
Eradication#
Eliminar la causa raíz:
- Remove malware.
- Patch vulnerabilidades explotadas.
- Reset credentials comprometidas.
- Remove accesos no autorizados.
- Rebuild sistemas si necesario.
Erradicar sin forense previo = perder visibilidad sobre scope real.
Recovery#
Volver a operación normal:
- Restore desde backups limpios.
- Validate sistemas antes de ponerlos online.
- Monitorización elevada durante días/semanas.
- Return to business comunicado.
Lessons Learned#
Post-mortem blame-free:
- Qué funcionó bien.
- Qué fallaron (controles, processes, people).
- Timeline detallado.
- Action items con ownership y due dates.
- Updates a playbooks.
Report compartido internamente. Ejecutivos leen executive summary; equipos técnicos leen detalle.
Playbook ejemplo: ransomware#
Para ilustrar, un playbook abreviado para ransomware:
# Playbook: Ransomware Incident

## Trigger
- Alerta EDR: mass file encryption pattern
- Reporte user: no puedo abrir archivos / rescate en pantalla

## Severity initial: Critical

## Immediate actions (first hour)
1. Activate IR team: oncall channel + conference bridge
2. Identify affected hosts via EDR
3. Network isolate affected hosts (do NOT power off)
4. Engage legal + cyber insurance contact
5. Preserve logs: SIEM queries saved

## Containment (hours 1-6)
1. Full scope assessment: ¿cuántos hosts? ¿servers vs workstations?
2. Identify ransomware family: hash, strings, nota
3. Check backups integrity + offline copies
4. Disable compromised accounts
5. Notify ejecutivos + comms team

## Forensics (hours 6-24)
1. Memory dumps from patient zero
2. Timeline reconstruction
3. Identify initial access vector
4. Map lateral movement
5. Identify exfiltration (check network logs)

## Decision point: pay or not
- Legal counsel involved
- Cyber insurance aligned
- Technical feasibility (backups available?)
- Reputational factors

## Eradication
1. Rebuild affected systems from clean images
2. Apply patches + hardening
3. Rotate all potentially compromised credentials
4. Hunt for persistence mechanisms

## Recovery
1. Restore from verified clean backups
2. Validate functionality
3. Enhanced monitoring 30 days
4. Communications: internal + external if required

## Post-incident
1. Blameless post-mortem
2. Update playbooks
3. Report to board
4. Lessons shared with industry (optional)
Cada organización tiene su playbook con detalles específicos (IPs internas, contactos, contratos insurance).
Roles del equipo IR#
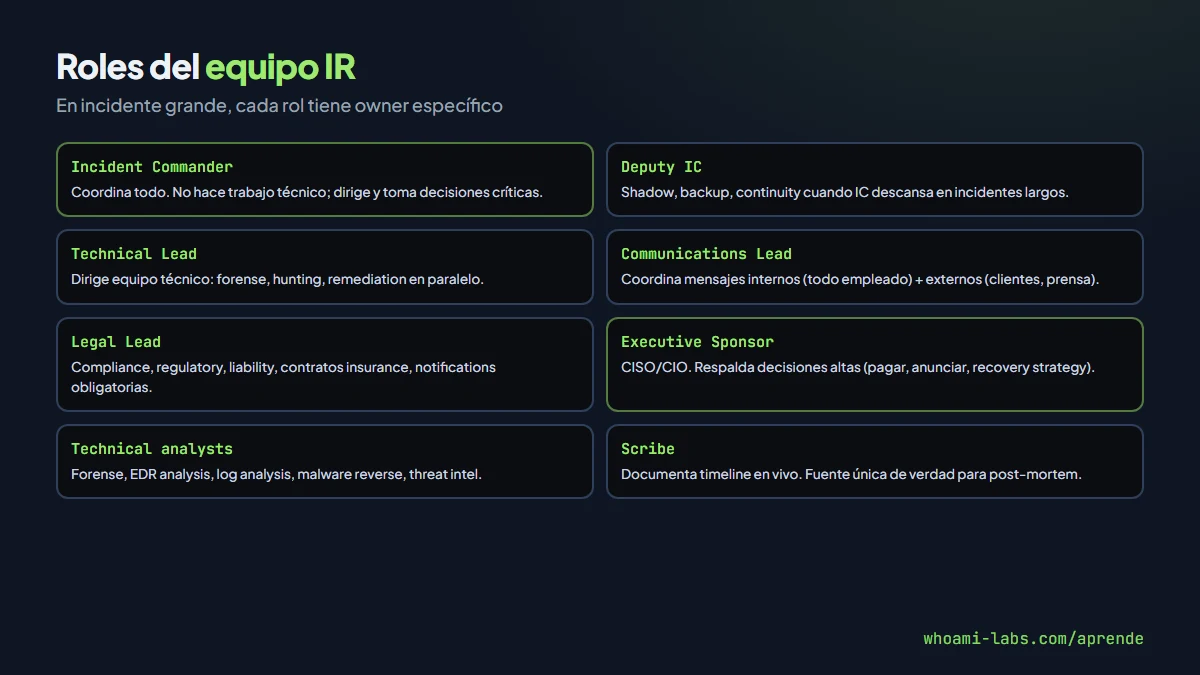
En incidente grande, roles diferenciados:
- Incident Commander (IC): coordina todo. No hace trabajo técnico; dirige.
- Deputy IC: shadow, backup, continuity cuando IC descansa.
- Technical Lead: dirige team técnico (forense, hunting, remediation).
- Communications Lead: coordina mensajes internos + externos.
- Legal Lead: compliance, regulatory, liability.
- Executive Sponsor: CISO/CIO que respalda decisiones altas.
- Technical analysts: forense, EDR analysis, log analysis.
- Scribe: documenta timeline en vivo.
Equipos pequeños combinan roles. Grandes los separan estrictamente.
Tooling IR típico#
- EDR (Defender, CrowdStrike, SentinelOne): detección + response + forense ligero.
- SIEM (Splunk, Sentinel, Elastic): queries sobre logs.
- Volatility / Rekall: memoria.
- Plaso / KAPE: artefactos Windows.
- Velociraptor: hunting + collection distribuido.
- TheHive + Cortex + MISP: case management.
- Keeper, 1Password Secrets Automation: rotación rápida creds.
- PagerDuty, Opsgenie: oncall.
- Slack/Teams dedicated channel: incident comms.
- War room video (Zoom/Meet): para incidentes grandes.
Comunicación efectiva#
Lecciones reales:
- Status updates regulares (cada 2-4 horas en incidente activo).
- Un lenguaje distinto para cada audiencia: técnico para técnicos, business para ejecutivos, jurídico para legal.
- No overcommit: «working on X» mejor que «X estará listo en Y».
- Facts primero, speculation después.
- Externals: coordinar con PR, legal, insurance antes de comunicar afuera.
- Documentar cada decision: para post-mortem y para posibles investigaciones legales.
NIST SP 800-61 vs SANS#
NIST publica SP 800-61 (Computer Security Incident Handling Guide): 4 fases (Preparation; Detection & Analysis; Containment, Eradication, Recovery; Post-Incident). SANS tiene 6 (desdobla containment/eradication/recovery). Mismo modelo, diferente granularidad.
Ambos son frameworks, no procesos rígidos. Adaptar a la organización.
Métricas clave#
Lo que mide un IR maduro:
- MTTD (Mean Time To Detect).
- MTTR (Mean Time To Respond).
- MTTC (Mean Time To Contain).
- Dwell time.
- % incidentes con root cause identified.
- % action items from post-mortems completed on time.
Industry benchmarks: Mandiant M-Trends reporta mediana global dwell time ~10 días en 2024, down from 200+ hace 10 años.
Tabletop exercises#
Un tabletop es simulación en sala de un incidente donde el equipo discute qué haría, sin tocar sistemas reales. Formato típico:
Facilitator presenta escenario: «viernes 16:00, llamada de un cliente: su data está en pastebin con nombre de nuestra empresa». El equipo responde: quién hace qué, qué canales, qué decisión en cada paso.
Facilitator inyecta complicaciones progresivas: «el CEO está en vacaciones», «el EDR ha caído», «la prensa llama», «el servidor de backup está también afectado».
Duración: 2-4 horas. Participantes: IR core team + ejecutivos + legal + PR.
Outcomes: identificar gaps en playbooks, roles no claros, decisiones mal definidas. Update de documentación con lecciones.
Industry crítica hace tabletops trimestrales. Resto anual mínimo. Los mejores incluyen también vendor IR partners.
IR en diferentes contextos#
Startup (10-100 personas)#
- 1-2 personas IR (parcial), resto equipo de engineering.
- Vendor IR retainer activo.
- Backup + MFA + EDR + SIEM básico.
- Playbooks cortos, tabletop anual.
Mid-market (100-5000)#
- IR team dedicado 2-10 personas.
- SOC propio o MSSP.
- Playbooks por tipo de incidente.
- Tabletops semestrales.
Enterprise (5000+)#
- IR team 10-50+ personas, 24/7 shifts.
- SOC propio con tiers L1/L2/L3.
- Threat hunting program dedicado.
- CSIRT formal con reporting a board.
- Tabletops trimestrales + Red team annual.
El framework es el mismo; la escala y madurez varían.
Errores comunes#
- IR como actividad reactiva sin preparation.
- Playbooks que nunca se practican.
- No test de backups (asumir que funcionan).
- Ejecutivos no involucrados = decisiones lentas en incidente.
- Un solo IC burnout (sin rotación en incidentes largos).
- Post-mortems con blame = culture tóxica, menos reporting.
- No learnings compartidos = repetir errores.
Preguntas frecuentes#
¿Vendor IR vs team interno?#
Depende del tamaño. <500 empleados: retainer con vendor + 1-2 analistas internos. 500-5000: team interno small + vendor para incidentes grandes. 5000+: team interno completo + vendor para expertise específica.
¿Cuántos tabletops al año?#
Mínimo 2 al año para equipo IR. Ejecutivos: 1 anual. Industry crítica (financiera, healthcare): 4+ al año.
¿Reporting a reguladores obligatorio?#
Depende de jurisdicción y data. GDPR: 72h si hay personal data. SEC rules (2023): 4 business days para material cyber incidents de public companies US. Healthcare HIPAA: 60 días. Cada industria tiene reglas específicas.
¿Documentar en real time es realista?#
Sí, es parte del rol del Scribe. Herramientas como TheHive automatizan mucho. Fuente única de verdad para post-mortem.
¿Dónde practico?#
El laboratorio snort de whoami-labs incluye tabletop completo: dado un escenario (ransomware o breach), simulas respuesta siguiendo los 6 pasos SANS. Al final comparas tu respuesta con un modelo de referencia.
¿Certificaciones recomendadas?#
GCIH (GIAC Certified Incident Handler, SANS SEC504) es la referencia entry-level. GCFA (Forensic Analyst) para forense profundo. GCFE (Forensic Examiner). CREST Practitioner en EU. Para managers: CISM, CISSP.
¿IR en cloud difiere mucho?#
Fuentes de datos cambian (CloudTrail en vez de syslog, CloudWatch en vez de Event Log), contención distinta (Security Group update en vez de network cable), pero el framework SANS/NIST aplica igual. Toolkits cloud-native: AWS Detective, GCP Chronicle, Azure Sentinel.
¿Diferencia entre IR y DFIR?#
DFIR (Digital Forensics and Incident Response) incluye ambas disciplinas. Forense profundo (memoria, disco, cadena de custodia legal) + response operacional. Muchos profesionales hacen ambas; algunos se especializan en forense pura.
¿Un IR solo en caso puede recuperar sin consultor externo?#
A veces, para incidentes pequeños. Para ransomware grande, breach regulatorio, o APT sospechado, consultor externo (Mandiant, CrowdStrike, Kroll) añade expertise + credibilidad ante reguladores y board.
¿Playbooks deben estar automatizados?#
Los pasos técnicos sí (SOAR platforms como XSOAR, Swimlane, Tines automatizan containment, enrichment, notificaciones). Decisiones críticas (pagar ransom, anunciar) siempre humanas.
Resumen#
- IR = gestionar incidente desde detección hasta cierre + aprendizaje.
- SANS 6 fases: Preparation, Identification, Containment, Eradication, Recovery, Lessons Learned.
- NIST SP 800-61 es equivalente con 4 fases.
- Preparation es la fase más importante.
- Roles: Incident Commander, Technical Lead, Communications, Legal, Scribe.
- Tooling: EDR + SIEM + memory/disk forense + case management + oncall.
- Métricas: MTTD, MTTR, MTTC, dwell time.
- Playbooks documentados + tabletops regulares = equipo preparado.
Esta lección cierra las 15 de la Tanda 5 y las 75 totales de /aprende hasta la fecha. El conjunto cubre desde fundamentos (permisos, Nmap, modelo OSI) hasta disciplinas avanzadas (AD advanced, cloud multiplataforma, mobile, forense, IR). Con todo este material, cualquier profesional puede construir un plan de aprendizaje estructurado para pentester junior, para analyst SOC, para red teamer o para arquitecto de seguridad.
El enfoque constante ha sido pedagógico: cada lección combina teoría suficiente para entender el fundamento, flujo práctico canónico, herramientas específicas para ejecutar, errores comunes para evitar trampas típicas, y referencias para profundizar. Los laboratorios prácticos de whoami-labs sirven de banco de pruebas controlado para fijar lo aprendido en entornos seguros y jurídicamente autorizados por diseño, sin riesgo legal para quien practica cada una de las técnicas cubiertas aquí a lo largo de las lecciones del catálogo completo de /aprende publicado en whoami-labs hasta la fecha actual.