Threat hunting: hipótesis, TTPs ATT&CK, queries y herramientas
· 10 min de lectura
Threat hunting es la búsqueda proactiva de atacantes dentro de la red asumiendo que están ya ahí. Aprende el método basado en hipótesis, ATT&CK como taxonomía, queries típicas en Splunk/Sentinel/Elastic y el loop de validación continua.
Threat hunting es la práctica defensiva más proactiva: asumir que un atacante ya está dentro de la red y buscarlo activamente, sin esperar a que una alerta salte. Nace de una observación simple: los atacantes sofisticados (APTs, ransomware operators modernos) tienen dwell time medio de 200+ días antes de ser detectados por herramientas automáticas. Durante ese tiempo exploran, pivotan, exfiltran. Las alertas tradicionales (SIEM rules, EDR signatures) cazan lo conocido; el threat hunter busca lo desconocido.
Esta lección cubre el ciclo canónico de threat hunting: formulación de hipótesis, uso de MITRE ATT&CK como taxonomía, queries típicas en plataformas (Splunk, Sentinel, Elastic), TTPs recurrentes a buscar y la mentalidad general. Es la segunda lección del bloque defensa avanzada de la Tanda 5, tras malware analysis.
Threat hunting es puramente defensivo, en entornos propios o con autorización explícita. No se practica en terceros.
El loop de threat hunting#
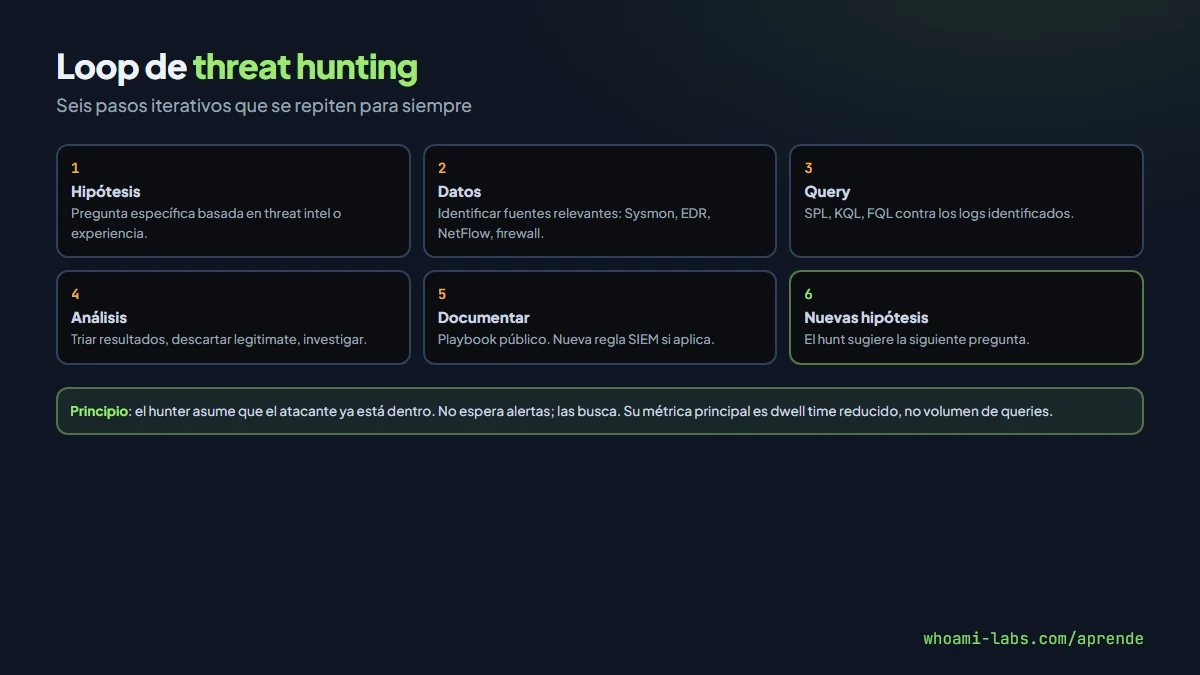
El flujo canónico (atribuido a David Bianco, Sqrrl):
Paso 1 — hipótesis: formular una pregunta específica basada en threat intel, ATT&CK, incidentes similares reportados, o experiencia. Ejemplo: «si un atacante está dentro, usaría certutil para descargar payloads porque pasa desapercibido».
Paso 2 — recolectar datos: identificar fuentes relevantes. Para esa hipótesis: logs de process creation (Sysmon event 1), logs de red (NetFlow), EDR telemetry.
Paso 3 — buscar: queries contra esos logs. process_name:certutil.exe AND command_line:*-urlcache*.
Paso 4 — analizar: triar resultados, descartar legitimate use, investigar lo sospechoso.
Paso 5 — documentar y escalar: incidente real → IR. Falso positivo → documentar para futuro. Hallazgo útil → nueva regla para SIEM.
Paso 6 — nuevas hipótesis: cada hunt sugiere nuevas preguntas.
El ciclo es iterativo. Un equipo maduro hunting cubre decenas de hipótesis al año y mantiene playbook público.
MITRE ATT&CK como taxonomía#
MITRE ATT&CK es la matriz de tácticas y técnicas usada por atacantes reales. 14 tácticas (Initial Access, Execution, Persistence, Privilege Escalation, Defense Evasion, Credential Access, Discovery, Lateral Movement, Collection, C2, Exfiltration, Impact, Reconnaissance, Resource Development) con cientos de técnicas y sub-técnicas.
Threat hunters usan ATT&CK para:
- Priorizar hipótesis: ¿qué técnicas usan los grupos que atacan nuestra industria?
- Mapear coverage: ¿qué técnicas cazamos ya, cuáles no?
- Compartir hallazgos: lenguaje común para describir qué viste.
Herramientas de coverage:
- ATT&CK Navigator: mapa visual de técnicas.
- DeTT&CT: scoring de detection capability por técnica.
- Atomic Red Team: tests de cada técnica para validar detecciones.
Ejemplos de hipótesis#
Hipótesis: Living off the Land binaries (LOLBINs)#
Atacantes abusan binarios legítimos (certutil, regsvr32, mshta, powershell) para pasar desapercibidos.
Query Splunk:
index=windows EventCode=1
| search (Image="*\\certutil.exe" CommandLine="*urlcache*")
  OR (Image="*\\regsvr32.exe" CommandLine="*http*")
  OR (Image="*\\mshta.exe" CommandLine="*http*")
| table _time ComputerName User CommandLine ParentImage
Query KQL (Sentinel):
DeviceProcessEvents
| where FileName in~ ("certutil.exe", "regsvr32.exe", "mshta.exe")
| where ProcessCommandLine has_any ("http", "urlcache")
| project Timestamp, DeviceName, AccountName, ProcessCommandLine, InitiatingProcessFileName
Análisis: certutil usado por admins para certificados → legítimo. Con -urlcache y URL → malicioso.
Hipótesis: PowerShell encoded commands#
Payloads en PowerShell suelen venir en base64 (-EncodedCommand).
DeviceProcessEvents
| where FileName =~ "powershell.exe"
| where ProcessCommandLine has_any ("-enc", "-EncodedCommand", "-ec ")
| extend DecodedCmd = base64_decodestring(extract(@"-[eE]\w* ([A-Za-z0-9+/=]+)", 1, ProcessCommandLine))
| project Timestamp, DeviceName, AccountName, DecodedCmd
El base64_decodestring revela el comando real. Buscar IEX, DownloadString, nombres de implants conocidos.
Hipótesis: anomalías de logon#
Logins fuera de patrón normal.
index=windows sourcetype=WinEventLog:Security EventCode=4624
| stats dc(ComputerName) as distinct_hosts by user
| where distinct_hosts > 5
Usuario logueando a más de 5 equipos distintos en periodo corto = movimiento lateral sospechoso.
Hipótesis: beacon C2#
Tráfico periódico a destino externo.
DeviceNetworkEvents
| summarize ConnectionCount = count(),
            IntervalVariance = stdev(datetime_diff('second', Timestamp, prev(Timestamp)))
  by DeviceName, RemoteIP
| where ConnectionCount > 100 and IntervalVariance < 60
Pocas conexiones + baja varianza en intervalos = beacon pattern (Cobalt Strike, Sliver sleep jitter bajo).
Hipótesis: persistencia nueva#
Scheduled task o service recién creado.
index=windows EventCode=4698 OR EventCode=7045
| where _time > relative_time(now(), "-24h")
| table _time ComputerName User TaskName ServiceName
Cada nueva task/service es candidato a investigación.
Herramientas y plataformas#
SIEMs#
- Splunk: dominante enterprise, query language SPL potente.
- Microsoft Sentinel: KQL, bien integrado con M365.
- Elastic SIEM / Security: open source friendly.
- Google Chronicle: data petabyte scale.
- IBM QRadar, LogRhythm: enterprise clásicos.
EDR#
- Microsoft Defender for Endpoint: KQL hunting integrado.
- CrowdStrike Falcon: Falcon Query Language (FQL).
- SentinelOne: Deep Visibility SQL-like.
- Elastic Endpoint: integrado con SIEM.
Open source#
- Velociraptor: endpoint hunting + IR tool open source brutalmente útil.
- osquery: queries SQL contra estado del sistema.
- Wazuh: SIEM + EDR open source.
- TheHive + Cortex + MISP: case management + enrichment + threat intel.
Threat intel feeds#
Para alimentar hipótesis:
- MITRE ATT&CK + Groups (APT29, APT41, etc.).
- MISP communities.
- AlienVault OTX.
- Mandiant reports, CrowdStrike reports, Microsoft Security.
- Twitter/Mastodon:
#threatintel,#malwareresearch. - The DFIR Report: writeups detallados periódicos.
- vendor-specific CTI: Recorded Future, Flashpoint, etc.
Métricas de un hunting program maduro#
- Hypotheses tested per quarter.
- True positives discovered (incidentes reales encontrados).
- New detections created.
- Dwell time reduction.
- Coverage ATT&CK (% de técnicas con detection).
Programas serios reportan estas métricas a dirección para justificar inversión.
Caza vs alerta#
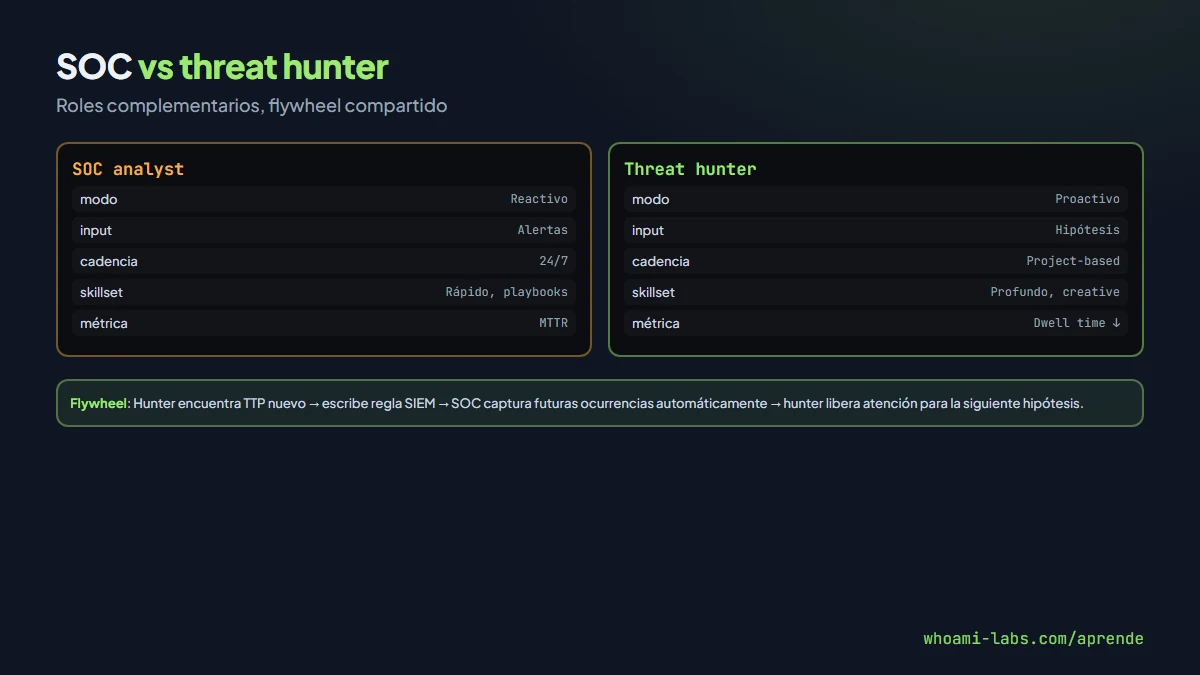
Diferencia operativa:
- SOC L1/L2: responde a alertas generadas por reglas/EDR. Reactivo.
- Threat Hunter: formula hipótesis, busca activamente. Proactivo.
El flywheel: hunter encuentra TTP nuevo → crea regla SIEM → SOC captura futuras ocurrencias automáticamente → hunter libera atención a siguiente hipótesis.
En organizaciones pequeñas, un analyst hace ambos roles. En grandes, equipo dedicado de 2-10 personas.
Pyramid of Pain#
Concepto clave de David Bianco. Las detecciones basadas en diferentes IOCs tienen distinto coste para el atacante:
| Nivel | IOC | Coste cambio atacante |
|---|---|---|
| Hash values | Fácil (recompila) | Trivial |
| IP addresses | Fácil (cambia C2) | Trivial |
| Domain names | Fácil | Trivial |
| Network artifacts | Medio (ajusta payload) | Molesto |
| Host artifacts | Medio (reescribe) | Molesto |
| Tools | Difícil (cambiar herramienta) | Caro |
| TTPs | Muy difícil (cambiar metodología) | Muy caro |
Cazar TTPs (tácticas, técnicas, procedimientos) obliga al atacante a cambiar su manera de operar, no solo un IOC. Es la caza más valiosa. Por eso ATT&CK y hunting basado en técnicas es el enfoque moderno vs blocklists de hashes/IPs.
Hipótesis avanzadas por industria#
Industrias distintas tienen amenazas distintas. Ejemplos:
- Financiero: cazar FIN7, FIN11, ransomware ALPHV. Hipótesis sobre magnetic stripe data access, SWIFT abuse.
- Salud: ransomware Conti variants, acceso a PII. Hipótesis sobre PACS systems, HL7 anomalies.
- Manufactura/OT: TRITON, PIPEDREAM. Hipótesis sobre comunicación IT-OT inusual, modificación de PLCs.
- Gobierno: APT groups por región (APT28, APT29, APT41, Lazarus). Hipótesis sobre supply chain, phishing dirigido.
- SaaS: Golden SAML, OAuth abuse. Hipótesis sobre new OAuth consents, token anomalies.
Alinear hunting con amenazas reales de tu industria es lo que diferencia un programa efectivo de uno de checklist.
Errores comunes#
- Hunting sin hipótesis: scrolling de dashboards random.
- No documentar hipótesis negadas (pierde valor de aprendizaje).
- Buscar solo lo que SIEM ya detecta (duplica trabajo).
- No cerrar el loop con new detection rule.
- Métricas vanity (número de queries) en vez de outcomes (incidentes encontrados).
- Ignorar threat intel → cazar lo que es relevante en otra industria pero no la propia.
Preguntas frecuentes#
¿Cuánto tiempo toma montar un hunting program?#
Pequeño programa con un analyst part-time: semanas. Equipo dedicado con metodología sólida: 3-6 meses. Madurez completa con coverage ATT&CK alto: años.
¿Vale la pena si no tenemos EDR enterprise?#
Sí. Hunting se puede hacer con logs Windows (Sysmon gratis), auditd Linux, firewall logs. EDR facilita pero no es prerequisito.
¿Cómo evitar burnout en hunters?#
Rotación de hipótesis, tiempo para escribir blog/rules compartibles, participación en community (DEF CON, SANS), no esperar big find cada semana (la mayoría de hunts son negativos).
¿IA/ML en threat hunting?#
Útil para anomaly detection (baselines), clustering de eventos, enrichment. No reemplaza hipótesis humana: el ML detecta anomalías, el humano juzga si son maliciosas.
¿Dónde practico?#
El laboratorio snort de whoami-labs incluye dataset simulado de logs Windows/Sysmon con ataque plantado: initial access → persistence → lateral → C2. Practicas formular hipótesis, correr queries KQL/SPL, y encontrar el atacante.
¿Carrera path para threat hunter?#
Analista SOC L1 → L2 → Threat Hunter junior → Threat Hunter senior → Principal/Lead. Algunos saltan desde incident responder o red teamer. Buenos hunters combinan experiencia ofensiva (saber cómo piensa el atacante) con defensiva (saber qué datos están disponibles).
¿Certificaciones relevantes?#
SANS FOR508, FOR572, CrowdStrike CCFR, GIAC GCFA/GCTI/GCFE. Más que cert, un portfolio con hunts documentados y threat intel reports escritos pesa en entrevistas.
¿Hunting en cloud difiere?#
Sí. Fuentes de datos cloud son distintas (CloudTrail, Azure Activity Log, GCP Audit Log). Hipótesis cloud-native: STS token abuse, console access anómalo, resource creation unusual. Mismo loop metodológico pero data sources distintos.
¿Un equipo de 2 personas puede hacer hunting serio?#
Sí, limitado. Rotación: una semana cada uno dedica a hunting, resto a SOC regular. Hipótesis priorizadas por impacto. No cubrirás ATT&CK completo pero cubrirás lo esencial de tu industria.
¿Hay formatos para compartir hunts con la comunidad?#
Sí: Sigma rules (reglas detection en YAML), threat hunting playbooks (Markdown), blog posts con query + explanation. Compartir normaliza nivel de madurez industry-wide.
Resumen#
- Threat hunting: asumir atacante presente, buscar proactivamente.
- Loop: hipótesis → datos → query → análisis → documentar → nuevas hipótesis.
- MITRE ATT&CK como taxonomía común.
- Patrones típicos: LOLBINs, PS encoded, anomalías logon, beacons C2, persistencia nueva.
- Plataformas: Splunk, Sentinel KQL, Elastic, Chronicle, CrowdStrike.
- Open source: Velociraptor, osquery, Wazuh, TheHive.
- Métricas: hipótesis testeadas, TPs reales, nuevas reglas, dwell time reducido.
Threat hunting en entornos sin SIEM enterprise#
Muchos equipos pequeños no tienen presupuesto para Splunk o Sentinel. Alternativas viables:
- Sysmon + Elastic + Kibana gratuito: cubre el 70% de hunting Windows.
- Wazuh: SIEM open source con reglas pre-escritas.
- Velociraptor: queries contra endpoints vivos sin SIEM.
- Logs directo en el endpoint:
wevtutil,journalctl, grep contra access logs.
El principio: la plataforma importa menos que la metodología. Un analyst con Sysmon y grep bien aplicados cazará más que uno con Splunk sin hipótesis claras.
El rol de la cultura#
Un programa de hunting exitoso depende tanto de la cultura como de las herramientas. Elementos clave:
- Tiempo protegido: hunters necesitan horas sin interrupciones.
- Permiso para fallar: 90% de hunts son negativos, es normal.
- Documentación sistemática: hunts negativos aún aportan valor.
- Sharing interno: equipos SOC, IR, blue team se benefician.
- Compartir externo: con la industria vía Sigma rules, writeups.
- Rotación: para no quemar analistas.
Las organizaciones que entienden esto ven ROI claro. Las que tratan hunting como «tareas extra del SOC» no obtienen beneficios reales. Es inversión organizacional, no tecnológica, y la cultura es lo que lo convierte en programa maduro.
La próxima lección cubre zero trust architecture, un enfoque defensivo sistemático que complementa threat hunting por diseño: en vez de buscar al atacante dentro una vez que entra, asumir por defecto que puede estar presente en cualquier parte del perímetro corporativo, que en arquitecturas modernas ya ni siquiera existe como concepto clásico unificado y claramente bien definido en el día a día operativo y diseñar controles de confianza mínima que limiten su capacidad de daño sin importar desde dónde consiga entrar inicialmente.