SAST, DAST y Secure Code Review: qué es, cómo se usa y cómo se integra en CI/CD
· 13 min de lectura
Análisis estático (Semgrep, CodeQL), dinámico (OWASP ZAP, Nuclei), IAST, SCA (Dependabot, Snyk), integración en CI/CD, triage de hallazgos y gestión de falsos positivos para construir un pipeline de seguridad efectivo.
Encontrar una vulnerabilidad en producción cuesta entre 10 y 100 veces más que encontrarla durante el desarrollo. Lo dice el NIST, lo confirma cada post-mortem de una brecha. La seguridad de aplicaciones (AppSec) ha evolucionado desde la auditoría manual de código una vez al año hasta los pipelines automatizados que escanean cada pull request. Las herramientas se dividen en dos grandes familias: análisis estático (SAST), que lee el código fuente sin ejecutarlo, y análisis dinámico (DAST), que ataca la aplicación en ejecución como lo haría un pentester.
Pero las herramientas por sí solas no resuelven el problema. Sin un proceso de triage, un equipo que recibe 500 hallazgos de Semgrep en su primer escaneo abandona la herramienta en una semana. Esta lección cubre las herramientas principales, cómo se integran en CI/CD, cómo se priorizan los hallazgos y los errores que hacen que un programa de AppSec fracase. Es la decimoquinta y última lección de la Tanda 10.
El análisis de seguridad se aplica a tu propio código y a las aplicaciones que tienes permiso de auditar. Escanear aplicaciones ajenas sin autorización es ilegal.
Qué es SAST, DAST y el secure code review#
El análisis de seguridad de aplicaciones se divide en varias técnicas complementarias que cubren diferentes fases del ciclo de vida del software:
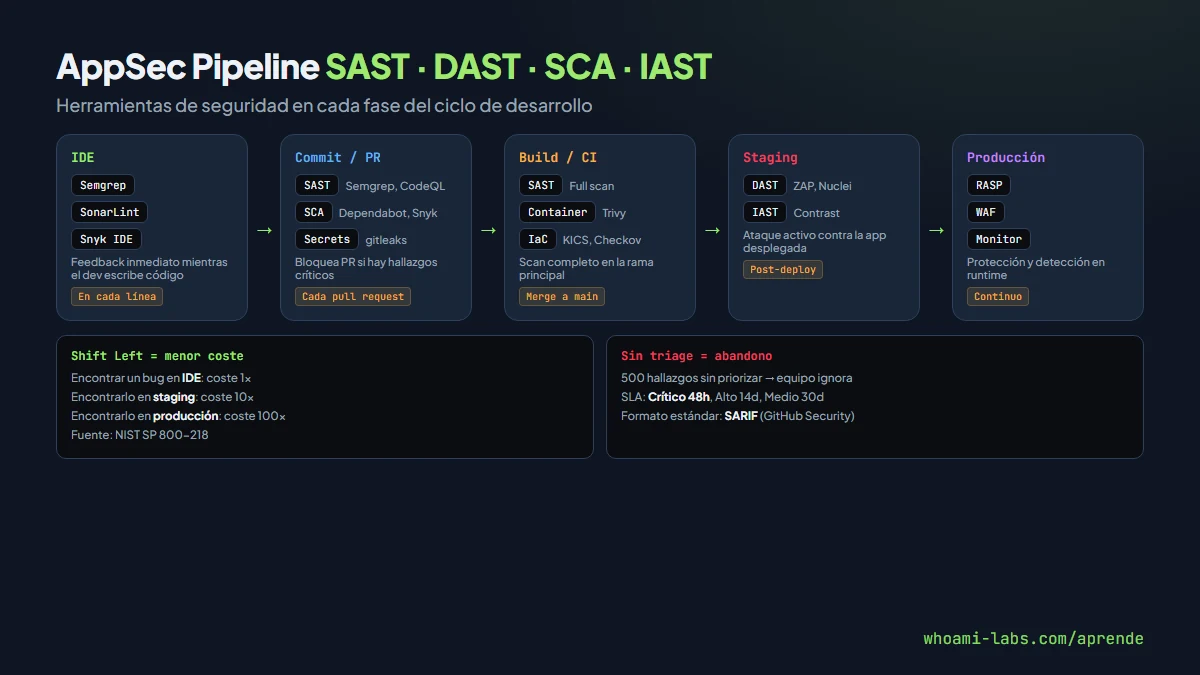
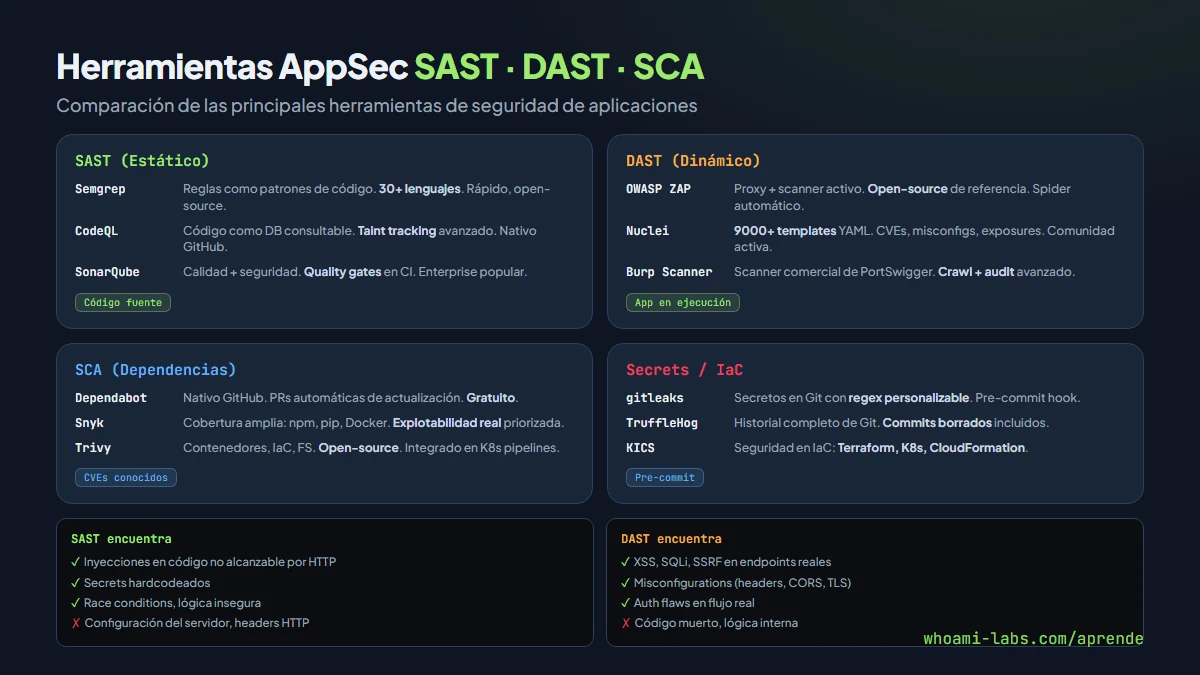
SAST (Static Application Security Testing) analiza el código fuente, bytecode o binarios sin ejecutar la aplicación. Lee el código como lo haría un revisor humano: sigue el flujo de datos desde las entradas (fuentes) hasta las operaciones sensibles (sumideros) buscando patrones de vulnerabilidad. Encuentra inyecciones, hardcoded secrets, race conditions y errores de lógica, pero no puede detectar fallos que solo se manifiestan en runtime (configuración del servidor, cabeceras HTTP, errores de autenticación en el flujo real).
DAST (Dynamic Application Security Testing) ataca la aplicación en ejecución enviando peticiones maliciosas y analizando las respuestas. Funciona como un escáner de vulnerabilidades web automatizado: prueba XSS, SQL injection, path traversal, SSRF y decenas de categorías más contra los endpoints reales. No necesita acceso al código fuente, pero solo encuentra lo que puede alcanzar a través de la interfaz HTTP.
IAST (Interactive Application Security Testing) combina ambos: instrumenta la aplicación con un agente que observa el flujo de datos en runtime. Cuando una entrada del usuario llega a una función peligrosa sin sanitizar, el agente lo reporta con el stack trace exacto. Es más preciso que SAST o DAST por separado, pero requiere un entorno de pruebas funcional y tiene overhead de rendimiento.
SCA (Software Composition Analysis) no analiza tu código, sino tus dependencias. Identifica bibliotecas con vulnerabilidades conocidas (CVEs) y licencias incompatibles. Herramientas como Dependabot, Snyk y Renovate automatizan la detección y la creación de pull requests con la versión parcheada.
Secure Code Review es la revisión manual del código por un experto en seguridad. Es la técnica más precisa pero la menos escalable. Se usa para lógica de negocio, criptografía, autenticación y cualquier área donde las herramientas automatizadas generan demasiados falsos positivos o no entienden el contexto.
Por qué ocurre: la causa raíz#
Las vulnerabilidades en el código llegan a producción porque:
- No hay escaneo en el pipeline: el equipo confía en las pruebas funcionales y los code reviews de funcionalidad, pero nadie revisa la seguridad.
- Shift-right en vez de shift-left: la seguridad se evalúa solo en pentests anuales, cuando el código ya está en producción y cambiarlo es caro.
- Herramientas mal configuradas: un SAST con reglas por defecto genera cientos de falsos positivos. El equipo lo ignora y pierde los verdaderos positivos en el ruido.
- Dependencias desactualizadas: el proyecto depende de librerías con CVEs conocidos, pero nadie ejecuta
npm auditni tiene Dependabot habilitado. - Falta de ownership: "la seguridad es cosa del equipo de seguridad". Sin responsabilidad compartida (DevSecOps), los hallazgos no se corrigen.
- Revisión de código sin checklist de seguridad: los code reviews se centran en estilo, rendimiento y funcionalidad. Sin un checklist explícito, las inyecciones y los fallos de autenticación pasan desapercibidos.
Tipos y variantes#
| Técnica | Qué analiza | Cuándo se ejecuta | Falsos positivos | Cobertura |
|---|---|---|---|---|
| SAST | Código fuente o bytecode | Commit, PR, IDE | Alta | Amplia pero sin contexto runtime |
| DAST | Aplicación en ejecución | Staging, pre-release | Baja | Solo endpoints alcanzables por HTTP |
| IAST | Runtime instrumentado | Tests de QA | Muy baja | Código ejecutado durante las pruebas |
| SCA | Dependencias (libraries) | Commit, schedule diario | Baja | Solo vulnerabilidades con CVE publicado |
| Manual code review | Lógica de negocio | Diseño, pre-release | Muy baja | Depende del revisor |
Dónde aparece#
- Pipelines de CI/CD: GitHub Actions, GitLab CI, Jenkins, Azure DevOps. El escaneo SAST y SCA se ejecuta en cada PR, DAST en cada despliegue a staging.
- IDEs del desarrollador: extensiones de Semgrep, Snyk y SonarLint muestran hallazgos mientras el desarrollador escribe código.
- Pentests y bug bounty: los pentesters usan DAST (ZAP, Nuclei, Burp Scanner) como primera fase de reconocimiento automatizado.
- Compliance (SOC 2, PCI-DSS, ISO 27001): los estándares de cumplimiento exigen evidencia de análisis de seguridad en el ciclo de desarrollo.
- Revisión de proveedores: antes de integrar una librería o un SaaS de terceros, SCA y revisión de seguridad del código del proveedor.
Cómo se detecta#
| Categoría de fallo | Herramienta SAST | Herramienta DAST |
|---|---|---|
| SQL injection | Semgrep, CodeQL | OWASP ZAP, Nuclei, sqlmap |
| XSS | Semgrep, CodeQL, SonarQube | OWASP ZAP, Burp Scanner |
| Path traversal / LFI | Semgrep (taint tracking) | Nuclei, OWASP ZAP |
| Hardcoded secrets | gitleaks, TruffleHog, Semgrep | No aplica |
| Dependencias vulnerables | Snyk, Dependabot, Trivy | No aplica |
| Configuración insegura | KICS, Checkov | Nuclei, Nikto |
| SSRF | CodeQL (taint tracking) | OWASP ZAP, Burp |
| Deserialización insegura | Semgrep | Nuclei (templates específicos) |
Herramientas principales#
- Semgrep: SAST open-source con reglas escritas como patrones de código. Soporta más de 30 lenguajes. Las reglas son legibles y personalizables.
- CodeQL: motor de análisis estático de GitHub. Trata el código como una base de datos consultable con un lenguaje propio (QL). Potente para taint tracking.
- OWASP ZAP: DAST open-source de referencia. Proxy de intercepción + escáner activo. Spider automático para descubrir endpoints.
- Nuclei: escáner de vulnerabilidades basado en templates YAML. Más de 9.000 templates de la comunidad para CVEs, misconfigurations y exposures.
- Snyk: SCA comercial con integración nativa en GitHub, GitLab, npm, pip y Docker. Genera PRs automáticas con la versión parcheada.
- Dependabot: SCA nativo de GitHub. Detecta dependencias vulnerables y crea PRs de actualización automáticamente.
- SonarQube: plataforma de calidad de código que incluye reglas de seguridad (SAST). Popular en entornos enterprise.
- Trivy: escáner de vulnerabilidades para contenedores, IaC y dependencias. Integrado en muchos pipelines de Kubernetes.
Explotación paso a paso en un laboratorio#
Paso 1 — Configurar Semgrep para análisis estático#
Instala Semgrep y ejecuta un escaneo contra el código del laboratorio:
# Instalar Semgrep
pip install semgrep

# Escanear con las reglas de seguridad de la comunidad
semgrep --config "p/owasp-top-ten" ./app/

# Escanear con reglas específicas de inyección
semgrep --config "p/sql-injection" --config "p/xss" ./app/
La salida muestra cada hallazgo con el archivo, la línea, la regla que lo detectó y la severidad. Ejemplo de hallazgo:
app/controllers/search.py
  security.python.sql-injection.sql-injection
    Possible SQL injection: user input concatenated in query string.
    Details: https://semgrep.dev/r/python.lang.security.audit.raw-query

    15| query = "SELECT * FROM users WHERE name = '" + request.args['name'] + "'"
Paso 2 — Ejecutar CodeQL contra un repositorio#
CodeQL requiere crear una base de datos del código y luego ejecutar consultas:
# Crear la base de datos CodeQL (ejemplo para Python)
codeql database create codeql-db --language=python --source-root=./app/

# Ejecutar las queries de seguridad estándar
codeql database analyze codeql-db \
  --format=sarif-latest \
  --output=resultados.sarif \
  codeql/python-queries:codeql-suites/python-security-extended.qls
El resultado en formato SARIF se puede importar en GitHub Security, VS Code o cualquier herramienta que lo soporte.
Paso 3 — Escaneo dinámico con OWASP ZAP#
Lanza ZAP contra la aplicación del laboratorio en modo headless:
# Escaneo activo con ZAP en modo CLI
docker run --rm -t ghcr.io/zaproxy/zaproxy:stable zap-full-scan.py \
  -t http://IP_DEL_LAB:8080 \
  -r reporte_zap.html \
  -a
ZAP descubre endpoints con su spider, luego lanza ataques activos (inyecciones, XSS, path traversal) contra cada parámetro encontrado. El reporte HTML detalla cada hallazgo con su riesgo, evidencia y recomendación.
Paso 4 — Escaneo con Nuclei#
Ejecuta Nuclei con templates de vulnerabilidades conocidas:
# Actualizar templates
nuclei -update-templates

# Escanear el laboratorio
nuclei -u http://IP_DEL_LAB:8080 -severity critical,high -o resultados_nuclei.txt

# Escanear con templates específicos de CVEs
nuclei -u http://IP_DEL_LAB:8080 -t cves/ -severity critical
Nuclei es especialmente eficaz para detectar CVEs conocidos en software desplegado (Apache, Nginx, WordPress, Jenkins, etc.) porque cada template está escrito específicamente para esa vulnerabilidad.
Paso 5 — Análisis de dependencias con Snyk o Trivy#
Escanea las dependencias del proyecto:
# Con Trivy (open-source)
trivy fs --security-checks vuln ./app/

# Con Snyk (requiere cuenta gratuita)
snyk test --all-projects

# Con npm audit (para proyectos Node.js)
cd app/ && npm audit --audit-level=high
La salida muestra cada dependencia vulnerable, el CVE asociado, la versión afectada y la versión parcheada disponible.
Paso 6 — Triage de hallazgos#
Con los resultados de SAST, DAST y SCA, prioriza:
1. Críticos confirmados: SQL injection, RCE, SSRF con evidencia → Fix inmediato
2. Altos con contexto: XSS en área autenticada, path traversal parcial → Sprint actual
3. Medios sin exploitability clara: info disclosure, headers faltantes → Backlog
4. Falsos positivos confirmados: marcar como "won't fix" con justificación
Qué puede lograr un atacante#
| Fallo no detectado | Impacto si llega a producción |
|---|---|
| SQL injection no detectada por SAST | Exfiltración de toda la base de datos |
| XSS almacenado ignorado en triage | Robo de sesiones de todos los usuarios |
| Dependencia con RCE conocido (CVE) | Ejecución remota de código en el servidor |
| Secret hardcodeado en código fuente | Acceso a infraestructura cloud, bases de datos, APIs |
| SSRF no detectada por DAST | Acceso a servicios internos, metadata de cloud, pivoting |
| Configuración insegura de headers | Clickjacking, MIME sniffing, downgrade de HTTPS |
Cómo se corrige#
Integrar SAST en cada pull request#
Configura Semgrep o CodeQL como check obligatorio en tu pipeline de CI:
# GitHub Actions: Semgrep en cada PR
name: Semgrep
on: [pull_request]
jobs:
  semgrep:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: returntocorp/semgrep-action@v1
        with:
          config: >-
            p/owasp-top-ten
            p/secrets
Para CodeQL en GitHub:
name: CodeQL
on:
  pull_request:
    branches: [main]
  schedule:
    - cron: '0 6 * * 1'
jobs:
  analyze:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: github/codeql-action/init@v3
        with:
          languages: python
      - uses: github/codeql-action/analyze@v3
Ejecutar DAST en staging automáticamente#
Lanza ZAP o Nuclei después de cada despliegue a staging:
# GitHub Actions: DAST con ZAP tras deploy a staging
name: DAST
on:
  workflow_run:
    workflows: ["Deploy to Staging"]
    types: [completed]
jobs:
  zap-scan:
    if: github.event.workflow_run.conclusion == 'success'
    runs-on: ubuntu-latest
    steps:
      - name: ZAP Scan
        uses: zaproxy/[email protected]
        with:
          target: 'https://staging.empresa.com'
          rules_file_name: 'zap-rules.tsv'
Habilitar SCA con actualizaciones automáticas#
Configura Dependabot en GitHub:
# .github/dependabot.yml
version: 2
updates:
  - package-ecosystem: "npm"
    directory: "/"
    schedule:
      interval: "weekly"
    open-pull-requests-limit: 10
  - package-ecosystem: "pip"
    directory: "/"
    schedule:
      interval: "weekly"
Establecer un proceso de triage#
Sin triage, los hallazgos se acumulan y el equipo los ignora. Define un SLA por severidad:
Crítico: fix en 24-48 horas (bloquea el release)
Alto: fix en 1 sprint (7-14 días)
Medio: fix en 2 sprints (30 días)
Bajo: backlog, revisión trimestral
Informativo: documentar, no requiere fix
Falso positivo: marcar con justificación para no volver a triagear
Escribir reglas personalizadas#
Las reglas por defecto no conocen tu aplicación. Escribe reglas Semgrep para tus patrones específicos:
rules:
  - id: mi-empresa.no-eval-user-input
    patterns:
      - pattern: eval($INPUT)
      - pattern-not: eval("constante")
    message: "No usar eval() con entrada del usuario"
    severity: ERROR
    languages: [python]
Errores comunes al defenderse#
- Activar todas las reglas desde el día uno: un proyecto legacy puede generar miles de hallazgos. Empieza con las reglas críticas (inyecciones, secrets) y amplía gradualmente.
- Tratar todos los hallazgos como bloqueantes: si el pipeline se rompe por un hallazgo informativo, el equipo desactiva el escáner. Configura severidades que bloqueen solo los críticos y altos confirmados.
- Confiar solo en SAST o solo en DAST: SAST encuentra vulnerabilidades en código que DAST no alcanza (rutas muertas, lógica interna). DAST encuentra configuraciones y comportamientos que SAST no ve (headers, cookies, errores de runtime). Son complementarios.
- No actualizar las reglas ni los templates: las herramientas de seguridad necesitan actualizaciones frecuentes para cubrir nuevas vulnerabilidades y CVEs.
- Ignorar los falsos positivos sin documentarlos: si no marcas un hallazgo como falso positivo con justificación, reaparecerá en cada escaneo y nadie lo revisará.
- No medir la cobertura: si el DAST solo descubre el 30 % de los endpoints porque el spider no puede autenticarse, tienes un falso sentido de seguridad. Configura autenticación en ZAP y verifica la cobertura del spider.
Preguntas frecuentes#
SAST o DAST: cuál implemento primero?#
SAST, porque se integra más fácilmente en el pipeline de CI y da feedback al desarrollador antes de que el código se despliegue. Empieza con Semgrep (ligero, rápido, open-source) en las PRs. Añade DAST cuando tengas un entorno de staging estable donde ejecutar escaneos sin impactar a los usuarios.
Semgrep o CodeQL: cuál es mejor?#
Depende del contexto. Semgrep es más rápido, más fácil de escribir reglas y funciona en cualquier CI. CodeQL es más potente para taint tracking y análisis interprocedural, pero solo funciona nativamente en GitHub (o con la CLI local). Para la mayoría de equipos, Semgrep es suficiente. Para organizaciones grandes con necesidades de análisis profundo, CodeQL complementa a Semgrep.
Cómo gestiono los falsos positivos?#
Cada herramienta tiene mecanismos de supresión. En Semgrep, añade un comentario # nosemgrep: rule-id con justificación. En CodeQL, usa las alertas de GitHub Security para descartar con razón. En ZAP, configura un archivo de exclusiones (contexts) para endpoints que no deben escanearse. Documenta siempre la razón: "este eval() procesa solo constantes del servidor" es una justificación válida; "no tenemos tiempo" no lo es.
IAST vale la pena?#
IAST (Contrast Security, Datadog IAST) tiene la tasa de falsos positivos más baja porque observa el flujo de datos real en runtime. Su coste es el overhead de rendimiento (5-15 %) y la necesidad de ejecutar las pruebas funcionales para que el agente observe el código. Si tu equipo tiene un suite de tests completo y el presupuesto lo permite, IAST es un complemento excelente. Si no, SAST + DAST cubren la mayoría de los casos.
Snyk, Dependabot o Renovate: cuál uso para SCA?#
Dependabot es gratuito y nativo de GitHub: si tu código está en GitHub, actívalo ya. Snyk tiene mejor cobertura de ecosistemas, priorización basada en explotabilidad real y soporte para contenedores. Renovate es el más configurable y soporta más plataformas (GitHub, GitLab, Bitbucket, Azure DevOps). Para la mayoría de equipos en GitHub, Dependabot es suficiente. Para organizaciones con múltiples ecosistemas, Snyk o Renovate.
Qué es SARIF y por qué importa?#
SARIF (Static Analysis Results Interchange Format) es un estándar JSON para resultados de análisis estático. Lo soportan Semgrep, CodeQL, ESLint, Checkov y muchas más herramientas. GitHub Security Dashboard importa SARIF directamente, lo que permite centralizar los hallazgos de múltiples herramientas en un solo lugar con tracking de estado (open, dismissed, fixed).
Resumen#
- SAST analiza el código fuente sin ejecutarlo (Semgrep, CodeQL). DAST ataca la aplicación en ejecución (ZAP, Nuclei). Son complementarios, no sustitutos.
- SCA (Dependabot, Snyk, Trivy) detecta dependencias con CVEs conocidos y automatiza la actualización con PRs.
- La integración en CI/CD convierte la seguridad en un check automático de cada PR, no en un pentest anual.
- El triage con SLA por severidad evita que el equipo se ahogue en hallazgos y abandone las herramientas.
- Las reglas personalizadas (Semgrep rules, CodeQL queries, Nuclei templates) adaptan las herramientas al contexto de tu aplicación.
- Medir la cobertura del escáner (endpoints descubiertos, código analizado) es tan importante como contar los hallazgos.