Rootkits eBPF y ejecución fileless en Linux: cómo funcionan, cómo se detectan y cómo se endurece el sistema
· 15 min de lectura
La post-explotación moderna en Linux usa eBPF para ocultar procesos y tráfico, memfd_create para ejecutar binarios que nunca tocan el disco y programas BPF anclados que viven sin ningún proceso. Aprende cómo funcionan a nivel conceptual y, sobre todo, cómo detectarlos con bpftool, auditd, Falco, Tracee y Tetragon y cómo endurecer el kernel.
La persistencia clásica en Linux (un crontab, un servicio de systemd, una clave SSH, un módulo del kernel) deja algo en el disco o un proceso en la lista. La post-explotación moderna intenta no dejar ninguna de las dos cosas.
Hoy un atacante que ya es root puede cargar un programa eBPF que reescribe lo que ven ps o ls, ejecutar un binario desde memoria con memfd_create sin que exista nunca como archivo y dejar programas BPF anclados que siguen funcionando sin ningún proceso suyo. Esta lección explica esas piezas a nivel conceptual y dedica la mayor parte del espacio a lo que importa al defensor: verlas, registrarlas y cerrar la puerta. Conviene haber leído antes persistencia en Linux y Linux capabilities. Es la decimocuarta lección de la Tanda 7.
Aviso ético: todo lo que aparece aquí es para entender, detectar y defender. Practica solo en máquinas virtuales propias o en laboratorios autorizados. Cargar código en el kernel de un sistema ajeno sin permiso es un delito en casi todos los países y puede dejar el equipo inutilizable.
Qué es un rootkit eBPF#
eBPF es una máquina virtual dentro del kernel de Linux. Permite cargar pequeños programas que se ejecutan cuando ocurre un evento: una syscall, la llegada de un paquete, la entrada a una función del kernel. Es la tecnología que hay debajo de Cilium, Falco, Tracee, Tetragon o bpftrace, y la forma estándar de observar un sistema sin tocar el código del kernel.
Un rootkit eBPF es lo mismo usado con otra intención: observa y manipula para esconder al atacante. Frente al rootkit LKM clásico tiene una ventaja para él: no hay que compilar un módulo para cada kernel, y el código pasa por el verificador, así que rara vez provoca un cuelgue que lo delate.
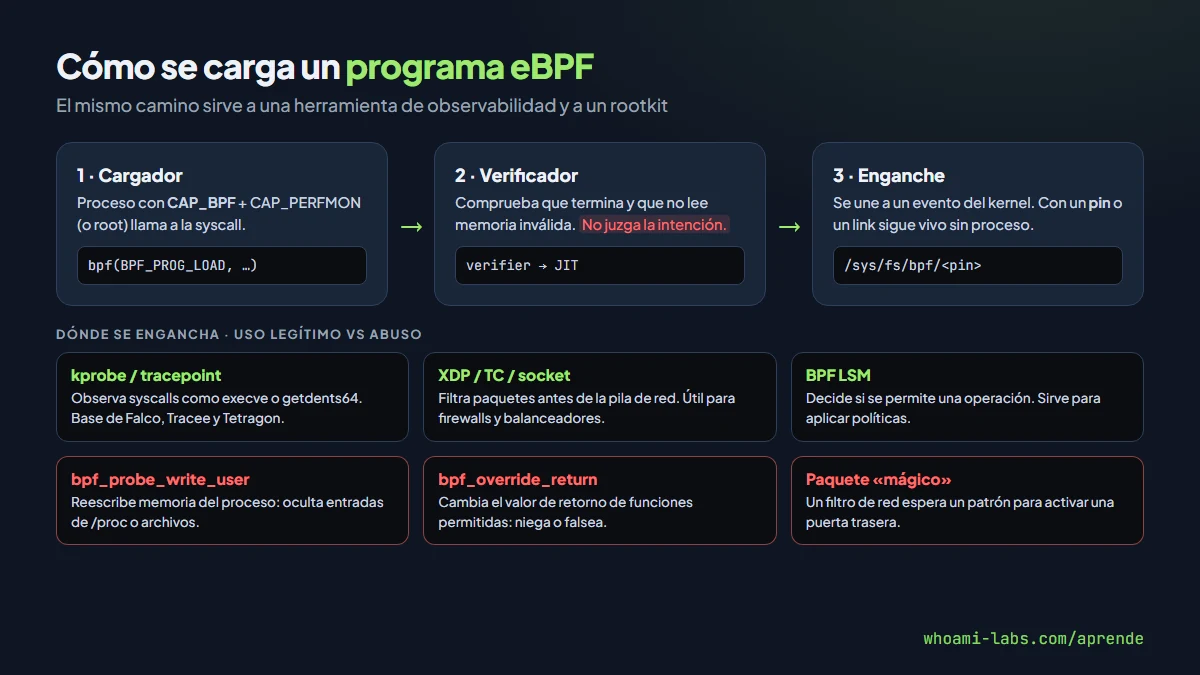
El ciclo de vida tiene tres pasos:
- Un proceso con privilegios llama a la syscall
bpf()con la ordenBPF_PROG_LOAD. - El verificador recorre todas las rutas del programa: que termine, que no lea memoria fuera de límites y que solo use funciones auxiliares (helpers) permitidas. Después, el JIT lo traduce a código máquina.
- El programa se engancha a un punto del kernel (kprobe, tracepoint, uprobe, XDP, TC, LSM) y habla con el espacio de usuario mediante mapas clave-valor.
La clave está en el segundo paso: el verificador garantiza que el programa es seguro para el kernel, no que sea bueno para ti. Un programa que miente sobre el contenido de un directorio es perfectamente válido.
Por qué ocurre: la causa raíz#
No hay una vulnerabilidad de eBPF detrás de estos rootkits. La causa es doble: el atacante ya tiene privilegios y el kernel ofrece, por diseño, helpers capaces de alterar lo que ven los procesos.
Desde el kernel 5.8 existe CAP_BPF, que separa los permisos de BPF de CAP_SYS_ADMIN. Según capabilities(7), los programas de trazado requieren CAP_BPF más CAP_PERFMON, y los de red, CAP_BPF más CAP_NET_ADMIN. En resumen: root, un contenedor privilegiado o un binario con esas capabilities puede cargar programas en el kernel.
Este es el esqueleto de un programa inofensivo que solo registra cada execve; las herramientas de seguridad usan el mismo patrón:
// Didáctico: solo observa, no modifica nada.
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

SEC("tracepoint/syscalls/sys_enter_execve")
int observa_execve(void *ctx)
{
    char comm[16];
    bpf_get_current_comm(&comm, sizeof(comm));
    bpf_printk("execve desde %s", comm);
    return 0;
}
char LICENSE[] SEC("license") = "GPL";
Lo que convierte algo así en un rootkit no es el enganche, sino los helpers:
| Helper o mecanismo | Qué permite | Por qué preocupa |
|---|---|---|
bpf_probe_write_user | Escribir en la memoria de usuario del proceso actual | Altera el búfer que devuelve una syscall antes de que el programa lo lea |
bpf_override_return | Cambiar el retorno de una función del kernel | Solo en funciones marcadas para inyección de errores y con CONFIG_BPF_KPROBE_OVERRIDE; niega o falsea operaciones |
bpf_send_signal | Enviar una señal al proceso actual | Puede matar herramientas de análisis al arrancar |
| Pin en bpffs o bpf_link | Mantener el programa tras cerrar el cargador | El programa vive sin proceso asociado |
La documentación de bpf_probe_write_user avisa de que está pensado para depuración. Por eso el kernel escribe una advertencia en su registro cada vez que se instala un programa que lo usa: es una de las mejores señales de detección que tienes.
Variantes de la post-explotación moderna#
Estas técnicas suelen combinarse: un implante se ejecuta desde memoria, carga BPF para esconderse y espera órdenes con un filtro de red.
| Técnica | Qué hace | Huella típica | ATT&CK |
|---|---|---|---|
| Rootkit LKM clásico | Módulo que engancha syscalls y se borra de la lista | Kernel tainted, módulo sin firmar | T1014, T1547.006 |
| Rootkit eBPF | Tracepoints o kprobes que reescriben resultados | Programas en bpftool, aviso de bpf_probe_write_user | T1014 |
| Puerta trasera con filtro BPF | Un filtro de socket espera un paquete «mágico» | Socket raw abierto por un proceso extraño | T1205.002 |
| Ejecución fileless con memfd | El binario solo existe en RAM | /proc/N/exe apunta a /memfd: | T1620 |
| Persistencia sin procesos | Programa anclado en /sys/fs/bpf | Objetos en bpffs sin dueño conocido | T1014 |
Casos públicos: BPFDoor (documentado en 2022) usa un filtro BPF clásico sobre un socket para esperar un paquete con un patrón concreto sin abrir puertos; Symbiote (2022) combina LD_PRELOAD con filtros BPF para ocultar su tráfico. En investigación, ebpfkit (Black Hat y DEF CON, 2021) y TripleCross demostraron rootkits eBPF completos.
Ocultar procesos y archivos#
ps y ls obtienen sus listas leyendo directorios con la syscall getdents64, sobre /proc o sobre la carpeta en cuestión. La lógica del rootkit, en alto nivel:
1. Engancharse a la salida de getdents64.
2. Recorrer el búfer de entradas que el kernel acaba de rellenar.
3. Si una entrada coincide con el PID o nombre a ocultar,
   absorberla en la anterior ajustando la longitud del registro.
4. Escribir el cambio en la memoria del proceso (bpf_probe_write_user).
Resultado: ps y ls no la ven, pero el proceso o archivo sigue ahí.
Fíjate en el punto débil: solo se miente al listar. Si preguntas directamente por /proc/1234, el kernel dice la verdad, salvo que el rootkit engañe también a otras syscalls. Esa asimetría es la base de la detección por vista cruzada.
memfd_create y fexecve#
memfd_create (kernel 3.17) crea un archivo anónimo en memoria. Si escribes un ELF en él y lo lanzas con fexecve, el programa corre sin haber existido en el sistema de archivos: no hay ruta que escanear ni hash en disco. Pero desde fuera se ve así:
$ ls -l /proc/4242/exe
lrwxrwxrwx 1 root root 0 ... /proc/4242/exe -> /memfd:kworker (deleted)
El nombre lo elige quien crea el memfd, por eso a veces imita hilos del kernel. El prefijo /memfd: no se puede quitar, y eso lo hace fácil de cazar.
Persistencia sin procesos#
Un programa BPF sigue cargado mientras algo lo referencie. Si el cargador lo ancla en /sys/fs/bpf, o ancla su bpf_link, puede terminar y el programa seguirá enganchado: sin PID, sin servicio, sin nada en ps.
El matiz: no sobrevive a un reinicio. Para volver tras un arranque, el atacante necesita una pieza clásica (servicio de systemd, cron, initramfs modificado). Esa pieza sí la puedes buscar en disco.
Cuándo es posible#
Nada de esto da acceso inicial: es post-explotación. Hace falta un servidor ya escalado a root, un contenedor con --privileged, CAP_SYS_ADMIN, CAP_BPF o el socket de Docker (comparte kernel con el host), o un binario con capabilities excesivas. Sin lockdown ni firma de módulos, además, las variantes LKM son triviales.
Cómo se detecta#
La regla de oro: inventaria antes de que te ataquen. Un servidor con Cilium o Falco tendrá decenas de programas BPF legítimos; sin línea base no sabrás cuál sobra.
| Comprobación | Comando o fuente | Qué buscar |
|---|---|---|
| Programas BPF | bpftool prog list | kprobes o tracepoints sin herramienta conocida detrás |
| Enlaces y pines | bpftool link list y /sys/fs/bpf | Objetos anclados que nadie instaló |
| Enganches perf | bpftool perf list | Qué proceso tiene cada kprobe o tracepoint |
| Helpers peligrosos | journalctl -k | El aviso de bpf_probe_write_user |
| Estado del kernel | /proc/sys/kernel/tainted | Distinto de 0: módulos fuera del árbol o sin firmar |
| Fileless | ls -l /proc/*/exe | Enlaces a /memfd: o binarios (deleted) |
| Vista cruzada | /proc/N directo frente a ps | PID que existe pero no aparece listado |
Auditoría de bpf, módulos y memfd#
auditd registra las syscalls en el kernel, antes de que un programa BPF pueda reescribir lo que ve el usuario. Si envías los registros a otro servidor, el atacante no puede borrarlos después:
# /etc/audit/rules.d/50-ebpf-fileless.rules
-a always,exit -F arch=b64 -S bpf -k ebpf_carga
-a always,exit -F arch=b64 -S init_module,finit_module,delete_module -k modulos_kernel
-a always,exit -F arch=b64 -S memfd_create -k memfd
Mide el volumen y filtra por ejecutable si tienes herramientas de observabilidad. Además, los kernels recientes emiten registros de auditoría de tipo BPF con op=LOAD y op=UNLOAD, un historial de cargas aunque el programa ya no esté.
Falco, Tracee y Tetragon#
Las tres usan eBPF para vigilar el kernel desde el mismo plano que el atacante:
- Falco (CNCF) evalúa reglas sobre eventos del kernel. Su campo
proc.is_exe_from_memfdpermite reglas de ejecución fileless, y sus conjuntos de reglas incluyen detecciones de carga de módulos y de la syscall bpf. - Tracee (Aqua Security) trae eventos de seguridad como
hooked_syscall(syscalls enganchadas) yhidden_kernel_module(módulos ocultos), además de eventos de carga y enganche de programas BPF. - Tetragon (Cilium) aplica políticas TracingPolicy sobre funciones del kernel y puede responder en tiempo real, por ejemplo matando el proceso que intenta cargar un programa no autorizado.
Si el rootkit se cargó antes que la herramienta, o puede matarla, llega tarde: arráncalas pronto y alerta si se caen.
Vista cruzada y forense de memoria#
Cuando sospechas que el kernel miente, compara fuentes que el rootkit difícilmente falseará a la vez:
- Accede directamente a cada
/proc/Nposible y compáralo conps; la herramientaunhideautomatiza la idea. - Captura la memoria (LiME o el hipervisor) y analízala en otro equipo con Volatility 3 (
linux.pslist,linux.check_syscall,linux.check_modules,linux.malfind). Más en análisis de memoria con Volatility. - Arranca desde un medio de confianza y revisa el disco en frío para encontrar la persistencia que recarga el rootkit.
Laboratorio paso a paso: observar y detectar en tu propia VM#
Este ejercicio solo usa herramientas legítimas y no oculta nada: el objetivo es reconocer las huellas. Usa una VM desechable (Ubuntu 22.04 o posterior, o Debian 12) con bpftool, bpftrace y auditd, y las reglas de auditoría de arriba cargadas.
Paso 1: línea base#
sudo bpftool prog list
sudo bpftool link list
sudo ls -R /sys/fs/bpf
sysctl kernel.unprivileged_bpf_disabled
cat /sys/kernel/security/lockdown
cat /proc/sys/kernel/tainted
Guarda la salida. Los programas cgroup_skb o cgroup_device de systemd son legítimos.
Paso 2: carga un programa benigno y obsérvalo#
En una terminal, traza los execve con bpftrace:
sudo bpftrace -e 'tracepoint:syscalls:sys_enter_execve { printf("%s -> %s\n", comm, str(args->filename)); }'En otra, repite el inventario:
sudo bpftool prog list | grep -A3 tracepoint
sudo bpftool perf list
sudo ausearch -k ebpf_carga --start recent | tail -n 20
Aparece un programa tracepoint con bpftrace como dueño y la llamada a bpf() en auditd. Cierra bpftrace: el programa desaparece porque no estaba anclado. Uno que siguiera ahí sin dueño sería justo lo que buscas en un incidente.
Paso 3: simula una ejecución fileless inofensiva#
Copia sleep a un memfd y ejecútalo desde ahí. Solo produce la huella:
# memfd_demo.py: solo para tu VM de pruebas
import os
fd = os.memfd_create("demo-memfd")
with open("/bin/sleep", "rb") as f:
    os.write(fd, f.read())
os.execve(fd, ["sleep", "300"], dict(os.environ))
python3 memfd_demo.py &
ls -l /proc/*/exe 2>/dev/null | grep memfd
sudo ausearch -k memfd --start recent/proc/N/exe mostrará /memfd:demo-memfd (deleted): la firma que buscan Falco y tus scripts de caza.
Paso 4: endurece y repite#
sudo sysctl -w vm.memfd_noexec=2     # kernel 6.3 o posterior
python3 memfd_demo.py                # ahora debería fallar
Con el valor 2, el kernel no permite memfd ejecutables en ese espacio de nombres de PID y el script falla (al crear el memfd o al ejecutarlo, según la versión). Si el sysctl no existe, tu kernel es anterior a 6.3: anótalo como hallazgo.
Paso 5: practica en los laboratorios#
Los labs no instalan rootkits, pero entrenan lo previo: llegar a root. breach (grupo docker), el-cuervo (capabilities), shadow-automation (enumeración), titan-linux (librerías y capabilities) y friend (kernel). Al ser root, ejecuta el paso 1 y piensa qué vería un defensor.
Qué puede lograr un atacante#
| Objetivo | Cómo lo consigue | Impacto |
|---|---|---|
| Invisibilidad | Ocultar PID, archivos y conexiones a ps, ls y ss | Las herramientas locales dejan de ser fiables |
| Puerta trasera silenciosa | Filtro de red que espera un paquete mágico | Acceso remoto sin puertos visibles |
| Robo de credenciales | uprobes sobre funciones de librerías | Datos leídos en claro antes de cifrarse |
| Sabotaje de la defensa | Señales a agentes o retornos falseados | EDR caído o con datos alterados |
| Ejecución sin disco | memfd_create y fexecve | Escaneo de archivos y hashes inútil |
| Supervivencia | Programa anclado más servicio o initramfs | Vuelve tras cada reinicio |
Cómo se corrige y se endurece#
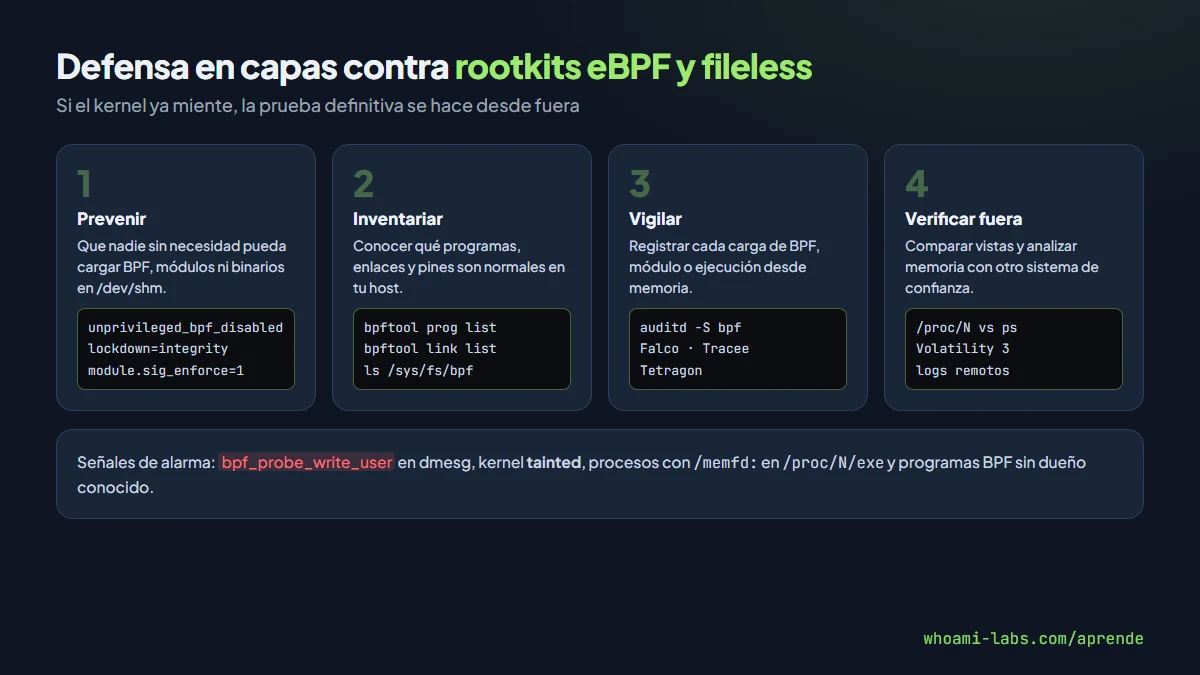
Ante un rootkit de kernel confirmado, reinstala desde una imagen de confianza y rota credenciales; limpiar un kernel comprometido en caliente no da garantías. El trabajo útil es previo: que cargar código en el kernel sea difícil y que, si ocurre, quede registrado fuera de la máquina.
# Antes (permisivo)
kernel.unprivileged_bpf_disabled = 0
net.core.bpf_jit_harden = 0
# sin lockdown, módulos sin firma aceptados, /dev/shm ejecutable
# Después: /etc/sysctl.d/90-ebpf-hardening.conf
kernel.unprivileged_bpf_disabled = 2 # 1 lo fija hasta reiniciar
net.core.bpf_jit_harden = 2
kernel.kptr_restrict = 2
vm.memfd_noexec = 2 # kernel 6.3 o posterior
# kernel.modules_disabled = 1 # solo si no cargas módulos tras arrancar
# Línea de arranque del kernel: lockdown=integrity module.sig_enforce=1
# /etc/fstab: tmpfs /dev/shm tmpfs defaults,nosuid,nodev,noexec 0 0Qué aporta cada medida:
- unprivileged_bpf_disabled: con 1 o 2, solo procesos privilegiados usan
bpf(). No frena a root, pero reduce la superficie del subsistema. - Lockdown (kernel 5.4 o posterior): en modo
integritybloquea módulos sin firma y escrituras en/dev/mem, y en kernels recientes restringebpf_probe_write_user. Muchas distribuciones lo activan con Secure Boot; compruébalo en/sys/kernel/security/lockdown. - Firma de módulos:
module.sig_enforce=1rechaza cualquier LKM sin firma válida. - Capabilities mínimas: nadie debería tener CAP_BPF, CAP_PERFMON o CAP_SYS_ADMIN sin necesidad. Revisa con
getcap -r / 2>/dev/null. - Contenedores: nada de
--privilegedni socket de Docker montado. El perfil seccomp por defecto de Docker no permitebpf()sin capacidades administrativas; en Kubernetes, aplica el estándar de podsrestricted. - Registros fuera del host: auditd, Falco o Tracee deben enviar eventos a un SIEM remoto. Un registro que solo vive en la máquina comprometida no es una prueba.
Errores comunes al defenderse#
- Confiar en
ps,lsossdel propio servidor para descartar un rootkit de kernel. - No tener línea base de programas BPF y no saber cuáles son legítimos.
- Creer que desactivar BPF sin privilegios resuelve el problema: el rootkit lo carga root.
- Buscar solo archivos en disco y olvidar
/proc/*/exe,/dev/shmy los memfd. - Matar el proceso sospechoso sin buscar la persistencia que recarga el rootkit.
- Guardar los registros de auditoría solo en local.
Preguntas frecuentes#
¿Un rootkit eBPF puede esconderse de bpftool?#
En principio sí. bpftool obtiene la lista mediante la propia syscall bpf(), y un rootkit puede interceptar esas respuestas igual que getdents64; la investigación pública lo ha demostrado. Por eso necesitas también registros enviados fuera desde el arranque y análisis de memoria en otro equipo.
¿Qué diferencia hay entre un rootkit LKM y uno eBPF?#
El LKM es código nativo sin restricciones: puede hacerlo todo, pero un error cuelga la máquina, marca el kernel como tainted y la firma de módulos lo bloquea bien. El eBPF está limitado por el verificador y los helpers, pero es más estable y portable entre versiones.
¿Reiniciar elimina un rootkit eBPF?#
Elimina los programas cargados, pero si queda un servicio, cron o initramfs que los recarga, volverán. Y reiniciar sin capturar memoria destruye la evidencia.
¿Cómo distingo un programa BPF legítimo de uno malicioso?#
Por contexto: qué proceso lo cargó (campo pids de bpftool), a qué se engancha, cuándo apareció y si coincide con una herramienta instalada. Un tracepoint sobre getdents64 sin agente de seguridad conocido detrás merece investigación inmediata.
Resumen#
- eBPF es legítimo; un rootkit eBPF lo usa para mentir a ps, ls y ss con helpers como bpf_probe_write_user.
- memfd_create y fexecve ejecutan binarios sin disco, pero dejan la huella
/memfd:en/proc/N/exe. - Un programa anclado en
/sys/fs/bpfsobrevive sin procesos, no a un reinicio: siempre hay una persistencia clásica que buscar. - Detecta con línea base de bpftool, auditd sobre bpf, módulos y memfd, Falco, Tracee o Tetragon, y vista cruzada.
- Endurece con unprivileged_bpf_disabled, lockdown, firma de módulos, vm.memfd_noexec y capabilities mínimas.
- Si el kernel está comprometido, la verdad está fuera: registros remotos, memoria analizada en otro equipo y reinstalación.
Fuentes y lecturas recomendadas#
- ebpf.io: qué es eBPF
- Documentación de BPF en kernel.org
- Página de manual bpf-helpers(7)
- Página de manual capabilities(7)
- Página de manual memfd_create(2)
- Kernel.org: sysctl del kernel
- Kernel.org: kernels tainted
- MITRE ATT&CK T1014: Rootkit
- MITRE ATT&CK T1205.002: Socket Filters
- MITRE ATT&CK T1620: Reflective Code Loading
- Documentación de Falco
- Documentación de Tracee
- Documentación de Tetragon