Bug bounty automation: Nuclei, ProjectDiscovery y pipelines de reconocimiento
· 10 min de lectura
Aprende a automatizar la fase de reconocimiento y detección de vulnerabilidades en bug bounty con Nuclei, httpx, subfinder y pipelines de monitorización continua que notifican nuevos hallazgos.
En la lección de bug bounty: metodología cubrimos cómo funciona el ecosistema, cómo elegir programa, qué escribir en un reporte y cómo escalar. Esta lección se centra en la parte más técnica: automatizar la fase de reconocimiento y detección para encontrar vulnerabilidades antes que otros cazadores, de forma repetible y escalable.
La diferencia entre un cazador que encuentra un bug al mes y uno que encuentra diez no suele ser la habilidad técnica: es la infraestructura de automatización. Los cazadores profesionales tienen pipelines que corren cada hora, comparan resultados con el día anterior, y les notifican cuando aparece un subdominio nuevo, un endpoint distinto o una tecnología desactualizada. Esa ventana de tiempo, entre que algo se despliega y alguien lo endurece, es donde se encuentran los mejores bugs.
Es la decimoquinta lección de la Tanda 9. Verás el stack de ProjectDiscovery (subfinder, httpx, nuclei, katana, notify), cómo escribir plantillas de Nuclei, cómo montar un pipeline completo de recon y cómo hacerlo de forma ética.
Ejecuta herramientas de escaneo solo contra targets dentro del scope del programa de bug bounty. Escanear sin autorización, aunque sea automatizado, es intrusión. Respeta los rate limits y el out-of-scope.
Por qué automatizar#
El reconocimiento manual es lento y no escala. Un programa de bug bounty con scope *.empresa.com puede tener cientos de subdominios, miles de endpoints y tecnologías que cambian cada semana. Revisar todo eso a mano cada vez que te sientas a cazar es ineficiente.
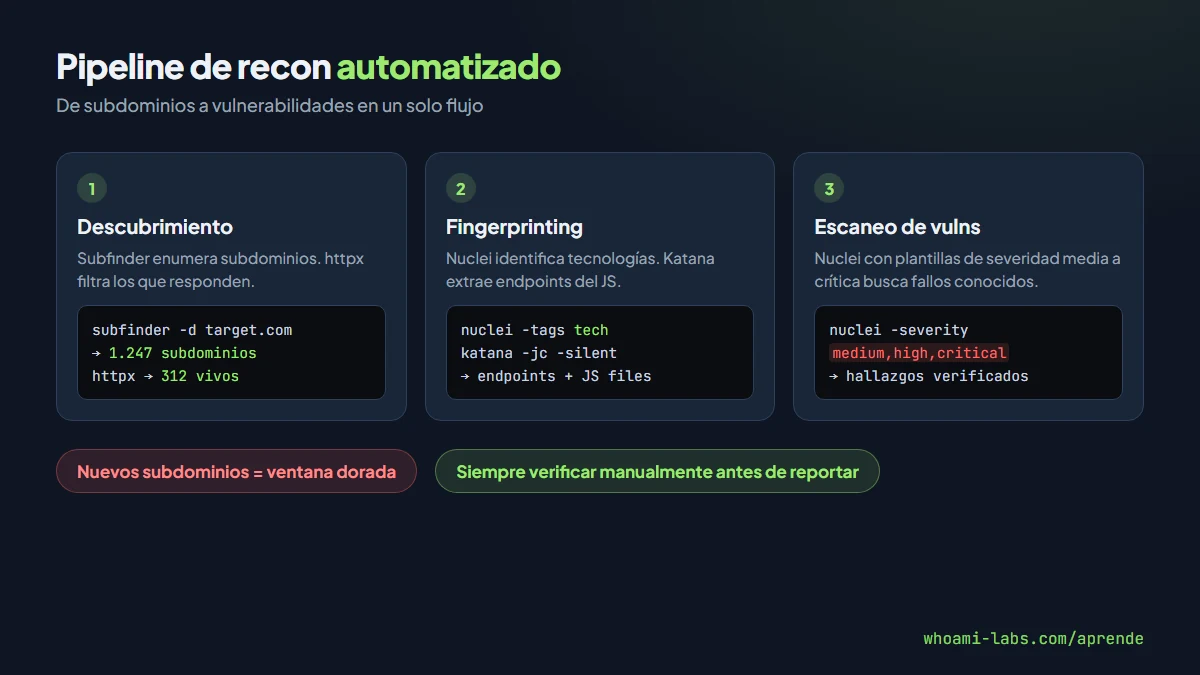
La automatización sirve para tres cosas:
- Cobertura: enumerar todo el scope, no solo lo que se ve a primera vista.
- Velocidad: detectar cambios antes que otros cazadores.
- Repetibilidad: el mismo pipeline corre una y otra vez sin error humano.
Lo que la automatización no sustituye es el análisis manual. Un scanner puede encontrar un CVE conocido, pero un bug de lógica de negocio requiere entender la aplicación. La combinación de ambos es lo que funciona.
El stack de ProjectDiscovery#
ProjectDiscovery es un ecosistema de herramientas de código abierto escritas en Go, diseñadas para encadenarse en pipelines. El stack principal:
| Herramienta | Función | Entrada | Salida |
|---|---|---|---|
| subfinder | Enumerar subdominios | Dominio raíz | Lista de subdominios |
| httpx | Probar qué hosts están vivos y recoger info | Lista de hosts | Hosts vivos con tecnologías y códigos |
| nuclei | Escanear vulnerabilidades con plantillas | Lista de URLs | Hallazgos categorizados |
| katana | Crawling y extracción de endpoints | Lista de URLs | Endpoints, JS files, formularios |
| notify | Enviar notificaciones | Texto de entrada | Mensaje en Telegram, Slack o Discord |
| uncover | Buscar en Shodan, Censys y otras APIs | Query | Hosts con servicios expuestos |
Instalación#
Todas se instalan con Go:
go install -v github.com/projectdiscovery/subfinder/v2/cmd/subfinder@latest
go install -v github.com/projectdiscovery/httpx/cmd/httpx@latest
go install -v github.com/projectdiscovery/nuclei/v3/cmd/nuclei@latest
go install -v github.com/projectdiscovery/katana/cmd/katana@latest
go install -v github.com/projectdiscovery/notify/cmd/notify@latest
Nuclei en profundidad#
Nuclei es el motor central del pipeline. Funciona con plantillas YAML que definen qué buscar y cómo detectarlo. La comunidad mantiene miles de plantillas en el repositorio nuclei-templates.
Estructura de una plantilla#
id: git-config-exposure

info:
  name: Git Config Exposure
  author: pdteam
  severity: medium
  description: Detecta archivos .git/config expuestos públicamente.
  tags: exposure,git,config

http:
  - method: GET
    path:
      - "{{BaseURL}}/.git/config"
    matchers:
      - type: word
        words:
          - "[core]"
          - "[remote"
        condition: and
      - type: status
        status:
          - 200
Ejecución básica#
# Escanear una lista de URLs con todas las plantillas
nuclei -l urls.txt -severity medium,high,critical -o resultados.txt

# Solo plantillas de tipo tech (fingerprinting)
nuclei -l urls.txt -tags tech

# Solo CVEs
nuclei -l urls.txt -tags cve

# Con rate limiting (peticiones por segundo)
nuclei -l urls.txt -rl 50 -severity high,critical
Plantillas personalizadas#
Puedes escribir tus propias plantillas para buscar patrones específicos de un programa:
id: custom-api-key-leak

info:
  name: API Key Leak in JavaScript
  author: tu-usuario
  severity: high
  tags: exposure,custom

http:
  - method: GET
    path:
      - "{{BaseURL}}/static/js/app.js"
      - "{{BaseURL}}/static/js/config.js"
    matchers:
      - type: regex
        regex:
          - "(?i)(api[_-]?key|apikey|secret[_-]?key)\\s*[:=]\\s*['\"][a-zA-Z0-9]{20,}['\"]"
Categorías de plantillas#
Las plantillas se organizan por tags y por severidad:
| Categoría | Qué busca | Ejemplo |
|---|---|---|
| cve | Vulnerabilidades con CVE asignado | CVE-2021-44228 (Log4Shell) |
| tech | Fingerprinting de tecnologías | Detectar versión de WordPress |
| exposure | Archivos o información expuesta | .git/config, .env, backup.sql |
| misconfig | Errores de configuración | Cors permisivo, directory listing |
| takeover | Subdomain takeover | CNAME apuntando a servicio cancelado |
| default-login | Credenciales por defecto | admin/admin en paneles |
Construir un pipeline de recon#
Un pipeline completo encadena las herramientas en un flujo donde la salida de una es la entrada de la siguiente:
#!/bin/bash
# recon.sh — Pipeline completo de reconocimiento
TARGET="$1"
DATE=$(date +%Y%m%d)
DIR="$HOME/recon/$TARGET/$DATE"
mkdir -p "$DIR"

echo "[*] Fase 1: subdominios"
subfinder -d "$TARGET" -silent > "$DIR/subs.txt"
echo "[+] $(wc -l < "$DIR/subs.txt") subdominios encontrados"

echo "[*] Fase 2: hosts vivos"
cat "$DIR/subs.txt" | httpx -silent -status-code -title -tech-detect \
  -o "$DIR/live.txt"
echo "[+] $(wc -l < "$DIR/live.txt") hosts vivos"

echo "[*] Fase 3: endpoints"
cat "$DIR/live.txt" | awk '{print $1}' | katana -jc -silent -d 3 \
  -o "$DIR/endpoints.txt"
echo "[+] $(wc -l < "$DIR/endpoints.txt") endpoints"

echo "[*] Fase 4: nuclei"
cat "$DIR/live.txt" | awk '{print $1}' | nuclei -rl 50 \
  -severity medium,high,critical -o "$DIR/vulns.txt"
echo "[+] $(wc -l < "$DIR/vulns.txt") hallazgos"
Fuentes adicionales de subdominios#
No te limites a subfinder. Combina fuentes para mayor cobertura:
# Certificate Transparency
curl -s "https://crt.sh/?q=%25.$TARGET&output=json" | jq -r '.[].name_value' | sort -u >> subs.txt

# Wayback Machine (endpoints históricos)
echo "$TARGET" | waybackurls > wayback-urls.txt

# GitHub dorking (buscar secretos en repos)
# Manual: site:github.com "empresa.com" password OR secret OR api_key
Monitorización continua#
El verdadero valor de la automatización es la monitorización continua. Los bugs más valiosos aparecen cuando un equipo despliega algo nuevo y todavía no lo ha endurecido.
Detectar subdominios nuevos#
#!/bin/bash
# new-subs.sh — Detecta subdominios nuevos comparando con el día anterior
TARGET="$1"
PREV="$HOME/recon/$TARGET/subs-prev.txt"
CURR="$HOME/recon/$TARGET/subs-curr.txt"

subfinder -d "$TARGET" -silent > "$CURR"

if [ -f "$PREV" ]; then
  NEW=$(comm -23 <(sort "$CURR") <(sort "$PREV"))
  if [ -n "$NEW" ]; then
    echo "$NEW" | notify -silent -provider-config ~/.config/notify/provider-config.yaml
    echo "$NEW" | httpx -silent | nuclei -severity medium,high,critical
  fi
fi

cp "$CURR" "$PREV"
Programar con cron#
# Cada 6 horas
0 */6 * * * /home/hunter/scripts/new-subs.sh empresa.com
Configurar notificaciones#
Notify soporta Telegram, Slack, Discord y otros. Configura ~/.config/notify/provider-config.yaml:
telegram:
  - id: "default"
    telegram_api_key: "TU_BOT_TOKEN"
    telegram_chat_id: "TU_CHAT_ID"
Cómo se detectan cambios#
Los cambios son señales de oportunidad:
- Subdominio nuevo: algo recién desplegado, posiblemente sin endurecer.
- Endpoint nuevo: funcionalidad que no existía ayer.
- Tecnología nueva: migración de stack que puede tener configuración por defecto.
- Certificado nuevo: indica actividad en un subdominio.
- Puerto nuevo abierto: servicio que antes no estaba expuesto.
Herramientas para diffing:
# anew: añade líneas nuevas que no estaban en el archivo
cat nuevo.txt | anew historico.txt

# comm: comparar listas ordenadas
comm -23 <(sort nuevo.txt) <(sort viejo.txt) > diferencias.txt
Explotación paso a paso en un laboratorio#
Los laboratorios ORION-RECON y RECON de whoami-labs están diseñados para practicar reconocimiento. Aquí un flujo típico:
Paso 1: enumerar servicios#
nmap -sV -sC -p- IP_DEL_LAB -o nmap-full.txtPaso 2: aplicar nuclei contra los servicios descubiertos#
echo "http://IP_DEL_LAB" | nuclei -tags tech -o tech.txt
echo "http://IP_DEL_LAB" | nuclei -tags exposure,misconfig -o findings.txt
Paso 3: crawling de endpoints#
echo "http://IP_DEL_LAB" | katana -jc -silent -d 5 -o endpoints.txtPaso 4: fuzz de rutas con plantillas específicas#
echo "http://IP_DEL_LAB" | nuclei -t ~/nuclei-templates/http/exposures/ -o exposures.txtPaso 5: verificar manualmente#
Abre Burp Suite y revisa cada hallazgo de nuclei. Confirma que es real, entiende el impacto y documenta los pasos para reproducirlo.
Qué puede lograr un hunter con automation#
| Resultado | Sin automation | Con automation |
|---|---|---|
| Subdominios descubiertos | 10-50 manualmente | 500-5.000 por target |
| Tiempo de recon por target | 2-4 horas | 15-30 minutos |
| Detección de cambios | «A veces reviso» | Notificación automática |
| CVEs conocidos | Los que recuerdas probar | Todos los que nuclei tenga plantilla |
| Cobertura de endpoints | Los que ves navegando | Miles via crawling y JS parsing |
Buenas prácticas y ética#
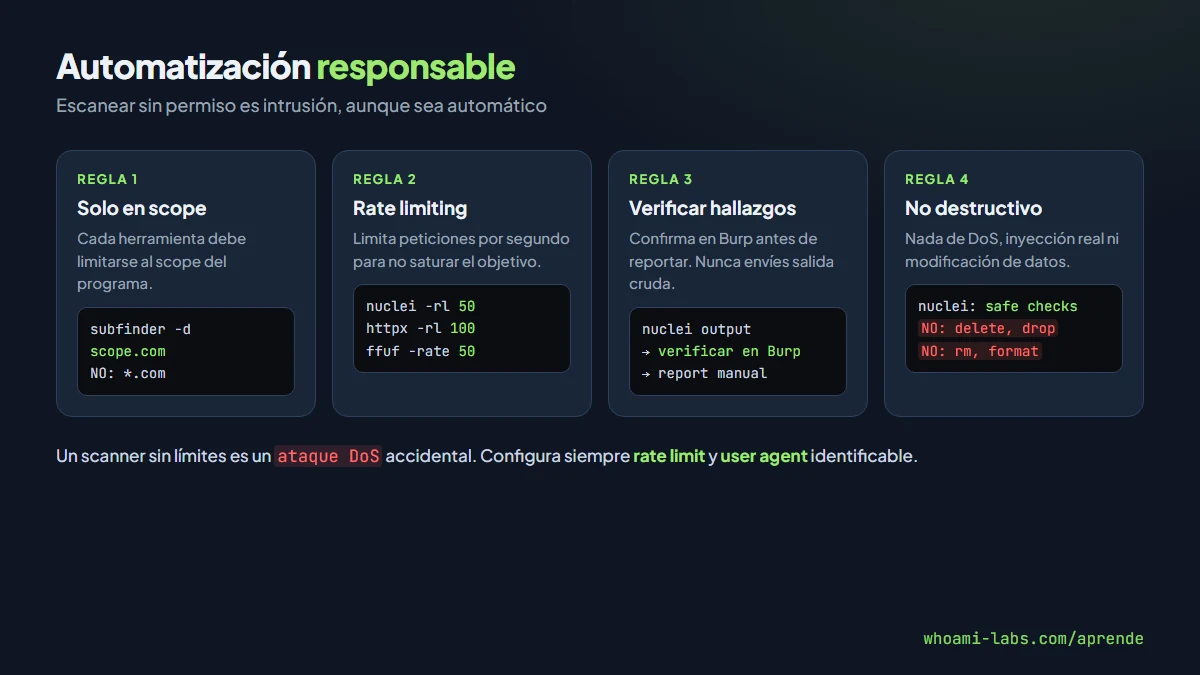
Respetar el scope#
Cada herramienta debe limitarse al scope del programa. No escanees dominios fuera del scope aunque los descubras durante el recon.
Rate limiting#
Configura siempre un límite de peticiones por segundo. Sin él, un scanner puede saturar el servidor y convertirse en un ataque DoS accidental:
# Nuclei: 50 peticiones por segundo
nuclei -l urls.txt -rl 50

# httpx: 100 peticiones por segundo
httpx -l subs.txt -rl 100

# ffuf: 50 peticiones por segundo
ffuf -w wordlist.txt -u https://target/FUZZ -rate 50
Verificar antes de reportar#
Nunca envíes la salida cruda de un scanner como reporte. Cada hallazgo debe ser verificado manualmente en Burp Suite o con curl. Los falsos positivos dañan tu reputación.
User-Agent identificable#
Configura un User-Agent que identifique quién eres. Algunos programas lo exigen:
nuclei -l urls.txt -H "User-Agent: BugBounty/tuUsuario [email protected]"No hacer pruebas destructivas#
Los scanners de nuclei tienen templates de tipo «safe» que solo leen. Evita templates que escriban, borren o modifiquen datos en producción.
Integración con Burp Suite#
Nuclei y Burp Suite no son rivales: se complementan. El flujo profesional es:
- Nuclei detecta un hallazgo potencial (por ejemplo, un endpoint que responde con un header sospechoso).
- Copias la URL y la petición al Repeater de Burp Suite.
- Reproduces el hallazgo manualmente, entiendes el impacto y documentas los pasos exactos.
- Si es un bug válido, escribes el reporte con PoC completo.
Los cazadores avanzados también usan la extensión de Burp Turbo Intruder para probar race conditions, Logger++ para filtrar peticiones interesantes y Autorize para detectar broken access control, todo sobre los endpoints que el pipeline automatizado descubrió.
Gestión de resultados#
Con cientos de hallazgos de nuclei, necesitas un sistema para gestionar qué has revisado y qué no:
# Marcar hallazgos como revisados
cat vulns.txt | sort -u > vulns-unique.txt
# Comparar con la lista de ya revisados
comm -23 vulns-unique.txt revisados.txt > pendientes.txt
Algunos cazadores usan bases de datos SQLite o herramientas como Notion y Obsidian para documentar cada programa, sus targets, los hallazgos y el estado de cada reporte.
Errores comunes#
- Reportar salida de nuclei sin verificar. Los triagers reconocen reportes automatizados y los marcan como spam.
- Escanear sin rate limit. El servidor se cae y el programa te banea.
- Ejecutar herramientas fuera del scope. Un subdominio de otra empresa compartiendo infraestructura no está en scope.
- No actualizar las plantillas de nuclei. Nuevas plantillas se publican cada semana. Sin actualizar, pierdes cobertura.
- Automatizar solo el recon y olvidar la explotación manual. Los bugs más valiosos (lógica de negocio, chain attacks) no los encuentra un scanner.
- Guardar credenciales del programa en el pipeline. Si tu script se filtra, las credenciales de API quedan expuestas.
Preguntas frecuentes#
¿Puedo usar nuclei sin programar?#
Sí. Las plantillas de la comunidad cubren miles de checks. Solo necesitas instalar nuclei, actualizar las plantillas con nuclei -update-templates y ejecutar contra una lista de URLs.
¿Nuclei reemplaza a Burp Suite?#
No. Nuclei automatiza la detección de vulnerabilidades conocidas, pero Burp Suite es indispensable para análisis manual, interceptar peticiones, probar lógica de negocio y explotar vulnerabilidades complejas. Son complementarios.
¿Cuánto tarda en ejecutarse un pipeline completo?#
Depende del tamaño del scope. Un target con 500 subdominios y 2.000 endpoints puede tardar entre 30 minutos y 2 horas con rate limiting moderado (50 rps).
¿Dónde practico recon automatizado?#
Los laboratorios ORION-RECON y RECON de whoami-labs están diseñados para enumerar servicios. También puedes practicar contra targets de bug bounty con scope amplio en programas públicos de HackerOne y Bugcrowd.
¿Las plantillas personalizadas dan ventaja?#
Mucho. Una plantilla que detecte un patrón específico de un programa (como una API key en un path concreto de su CDN) puede encontrar bugs que nadie más busca. Los cazadores profesionales mantienen colecciones privadas de plantillas.
¿Cómo evito que me baneen del programa?#
Rate limiting es la clave. Usa -rl 50 en nuclei, distribuye el escaneo a lo largo de horas, configura un User-Agent identificable y lee las reglas del programa sobre automated scanning. Algunos programas prohíben el escaneo automatizado por completo; otros lo permiten con restricciones. Si el programa dice «no automated scanning», limítate a herramientas manuales como Burp Suite.
¿Qué hago con los falsos positivos de nuclei?#
Los falsos positivos son inevitables. Cuando nuclei reporta un hallazgo, abre la URL en el navegador o en Burp y confirma manualmente. Si confirmas que es falso positivo, puedes excluir esa plantilla para ese target con -exclude-templates o marcar la URL como revisada en tu sistema de gestión.
Resumen#
- La automatización de recon multiplica la cobertura, la velocidad y la repetibilidad del bug hunting.
- El stack de ProjectDiscovery (subfinder, httpx, nuclei, katana, notify) encadena descubrimiento, fingerprinting y detección en un pipeline.
- Nuclei usa plantillas YAML para detectar CVEs, exposiciones, misconfiguraciones y takeovers. Las plantillas personalizadas dan ventaja competitiva.
- La monitorización continua detecta cambios (subdominios nuevos, endpoints, tecnologías) que son la ventana dorada para encontrar bugs.
- La ética es innegociable: scope, rate limiting, verificación manual y nada destructivo.