SOC detection engineering: Sigma, YARA, Suricata y threat hunting
· 12 min de lectura
El SOC moderno no sobrevive con alertas genéricas. Aprende detection engineering: escribir reglas Sigma, YARA, Suricata de calidad, reducir false positives, threat hunting proactivo, y construir detection-as-code pipelines que escalan.
Detection engineering es la disciplina de crear, probar, mantener y mejorar reglas de detección de amenazas para SOCs (Security Operations Centers). No es solo "escribir alertas" — es ingeniería de software aplicada a seguridad: versionado, testing, CI/CD, métricas de calidad, y lifecycle management.
Un SOC que depende de reglas vendor-default genera miles de falsos positivos que queman al equipo de analistas. Detection engineering construye detecciones a medida del entorno, probadas contra datos reales, con false positive rate medido y tuneado. Esta lección cubre el framework completo: lenguajes de detección (Sigma, YARA, Suricata), metodología de desarrollo, testing, y threat hunting como complemento. Es la duodécima lección de la Tanda 7.
Detection engineering es disciplina blue team. Conocimiento ofensivo complementa pero la mentalidad aquí es de defensor: proteger infraestructura, detectar adversarios, reducir tiempo de respuesta.
El problema de las detecciones genéricas#
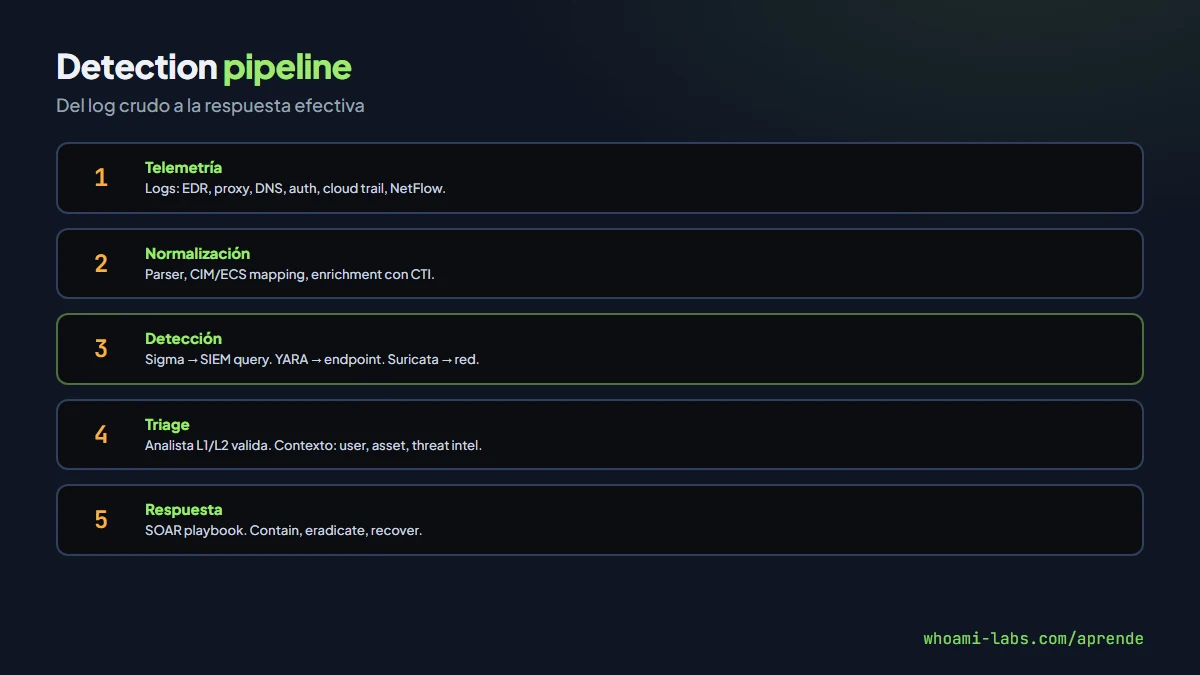
SOCs típicos sufren de:
- Alert fatigue: cientos o miles de alertas diarias, la mayoría falsos positivos. Los analistas se desensibilizan y acaban cerrando alertas sin mirarlas.
- Vendor lock-in: las reglas que trae el SIEM son cajas negras, difíciles de adaptar y de probar.
- Cobertura inconsistente: MITRE ATT&CK describe cientos de técnicas y subtécnicas, y pocos SOC saben con certeza cuáles detectan y cuáles no.
- Reglas obsoletas: detecciones que nadie revisó en años, generando ruido sin valor.
- Sin testing: nadie prueba si la regla detecta lo que dice detectar.
Detection engineering soluciona estos problemas aplicando prácticas de software engineering a las detecciones.
Los tres lenguajes de detección#
Cada lenguaje mira una capa distinta. Un SOC maduro usa los tres y los correlaciona.
| Lenguaje | Qué inspecciona | Dónde se ejecuta | Pregunta que responde |
|---|---|---|---|
| Sigma | Eventos de log (procesos, autenticación, cloud) | SIEM, tras conversión | ¿Qué comportamiento ocurrió en el sistema? |
| YARA | Bytes de archivos y memoria | EDR, sandbox, forense | ¿Este archivo o proceso es malware conocido? |
| Suricata | Paquetes y flujos de red | Sensor IDS/IPS | ¿Qué cruzó la red y con qué protocolo? |
Las reglas de comportamiento (Sigma) envejecen mejor que las firmas de bytes (YARA) o de contenido de red (Suricata): un atacante cambia un hash en segundos, pero le cuesta mucho más cambiar la técnica.
Sigma: lenguaje universal de detección#
Sigma es el formato estándar para describir detecciones agnósticas de SIEM. Una regla Sigma describe QUÉ detectar; un conversor (sigmac, pySigma) traduce a la query del SIEM específico (Splunk SPL, Elastic KQL, Microsoft KQL, Chronicle YARA-L, QRadar AQL).
title: Suspicious PowerShell Download Cradle
id: 3b6ab547-b2c2-4c4e-9b53-3c2d72f9d2b1
status: test
description: Detects PowerShell downloading and executing payloads
logsource:
    category: process_creation
    product: windows
detection:
    selection:
        CommandLine|contains|all:
            - 'powershell'
            - 'downloadstring'
    condition: selection
level: high
tags:
    - attack.execution
    - attack.t1059.001
Ventajas de Sigma:
- Portabilidad: misma regla funciona en cualquier SIEM.
- Comunidad: el repositorio SigmaHQ mantiene miles de reglas revisadas por la comunidad.
- Versionable: YAML en Git, reviewable, diffable.
- Testable: pySigma permite unit testing con eventos simulados.
Anatomía de una buena regla Sigma#
- Título descriptivo: qué detecta, no cómo.
- UUID estable: no cambia entre versiones.
- Logsource clara:
product + category + service. - Detection precisa: condiciones que minimizan false positives.
- Level apropiado: critical/high/medium/low/informational.
- Tags MITRE: tactic + technique IDs.
- False positives documentados: qué actividad legítima puede triggearla.
YARA: detección en archivos y memoria#
YARA detecta patrones en archivos, procesos en memoria, tráfico de red. Es el estándar de facto para malware classification y threat intelligence. El siguiente ejemplo es didáctico: muestra la estructura (metadatos, cadenas y condición), no es una firma de producción.
rule Cobalt_Strike_Beacon_Config {
    meta:
        description = "Detects Cobalt Strike beacon configuration"
        author = "whoami-labs"
        reference = "Internal research"
    strings:
        $config_start = { 00 01 00 01 00 02 }
        $sleep_mask = "SleepMask" ascii
        $pipe_name = "\\\\.\\pipe\\" ascii
    condition:
        uint16(0) == 0x5A4D and
        filesize < 500KB and
        ($config_start or ($sleep_mask and $pipe_name))
}
YARA rules se despliegan en:
- EDR agents: scan de archivos en endpoint.
- Sandbox analysis: clasificación automática de samples.
- YARA-X: rewrite moderno de YARA en Rust, más rápido.
- Memory forensics: Volatility + YARA para scan de procesos.
- Email gateway: scan de adjuntos.
- Network: scan de payloads extraídos de tráfico.
Suricata: detección en red#
Suricata es IDS/IPS open-source que inspecciona tráfico de red con reglas de signature:
alert http $HOME_NET any -> $EXTERNAL_NET any (
    msg:"WHOAMI - Suspicious User-Agent PowerShell";
    flow:to_server,established;
    http.user_agent; content:"PowerShell";
    classtype:trojan-activity;
    sid:1000001; rev:1;
)
Suricata procesa:
- HTTP/TLS/DNS/SMB/etc. protocol parsing.
- JA3/JA3S: TLS fingerprinting.
- File extraction: extraer archivos de tráfico para análisis.
- Flow logging: metadata de conexiones.
Deployment típico: tap de red o mirror port, Suricata procesa todo el tráfico, logs a SIEM para correlación.
Detection-as-Code#
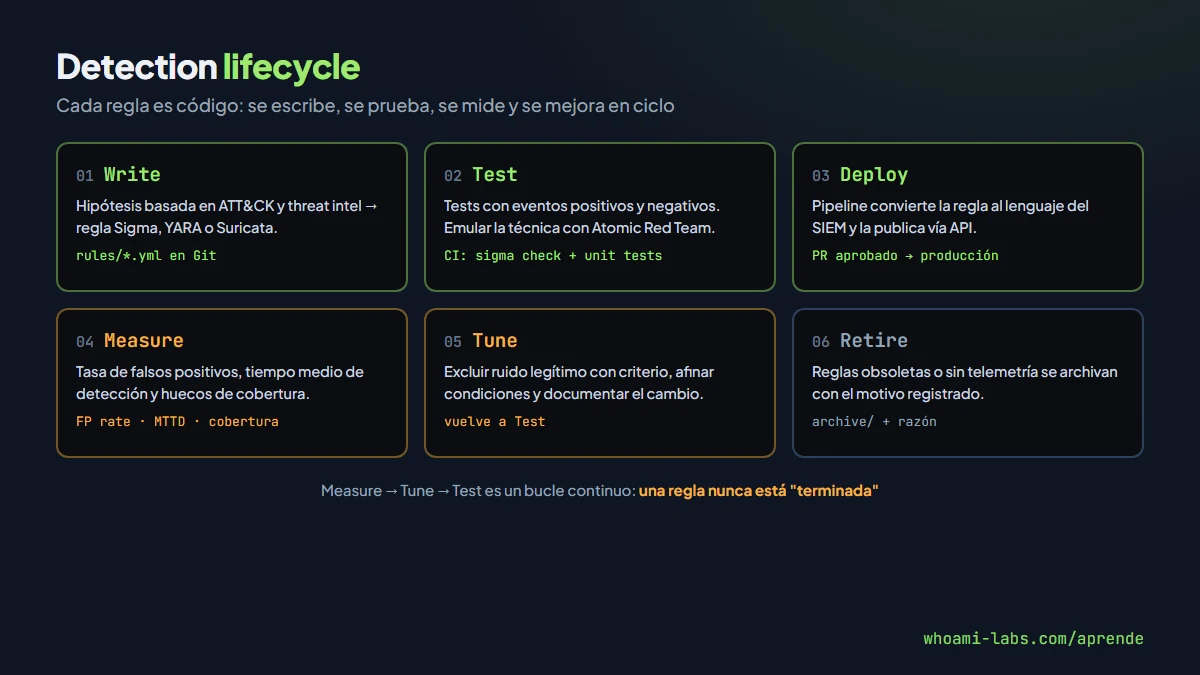
Tratar detecciones como código:
Repositorio Git#
detections/
├── sigma/
│   ├── windows/
│   │   ├── process_creation/
│   │   └── registry_events/
│   └── linux/
├── yara/
│   ├── malware/
│   └── webshells/
├── suricata/
│   └── custom.rules
├── tests/
│   ├── true_positives/
│   └── false_positives/
└── CI/
    └── pipeline.yml
CI/CD pipeline#
- Lint: validar sintaxis (pySigma validate, YARA compile check).
- Unit test: evento true positive → regla detecta. Evento benign → regla no detecta.
- Integration test: contra logs reales anonimizados del entorno.
- Deploy: push a SIEM production (API o config management).
- Metrics: false positive rate, true positive rate, time-to-detect.
Métricas de calidad#
| Métrica | Qué mide | Señal de alarma |
|---|---|---|
| Cobertura ATT&CK | Técnicas relevantes con al menos una detección probada | Técnicas prioritarias sin regla ni hunt |
| Tasa de falsos positivos | Alertas benignas frente al total por regla | Una regla que casi nunca acierta |
| MTTD | Tiempo desde el evento hasta la alerta | Retrasos de ingesta de horas |
| MTTR | Tiempo desde la alerta hasta la contención | Alertas sin runbook de triage |
| Salud de la regla | Reglas que no disparan desde hace meses | La fuente de logs dejó de llegar y nadie lo notó |
La última es la más traicionera: una regla que nunca dispara puede significar que no hay ataques, o que el log del que depende lleva semanas sin llegar. Por eso conviene alertar también sobre fuentes silenciosas.
Threat hunting#
Hunting es búsqueda proactiva de amenazas que las reglas automáticas no detectaron. No reemplaza detections sino complementa:
- Hypothesis-driven: "Adversario podría estar usando DNS tunneling para exfiltración."
- Data sources: logs de EDR, NetFlow, proxy, DNS, auth, cloud trail.
- Tools: Jupyter notebooks + pandas para análisis, SIEM queries, Velociraptor para endpoint.
- Output: si encuentras algo → incidente. Si no pero la hipótesis era válida → nueva regla de detección.
MITRE ATT&CK como framework de priorización#
ATT&CK provee la taxonomía para priorizar detecciones:
- Mapear las técnicas más usadas por threat actors relevantes a tu industria.
- Evaluar cobertura actual de cada técnica.
- Priorizar gaps en técnicas de alto impacto.
- Desarrollar detecciones + hunts para cerrar gaps.
Threat intelligence feeds (MISP, OpenCTI, AlienVault OTX) proporcionan IOCs y TTPs de adversarios activos que alimentan tanto detecciones como hunting hypotheses.
Construyendo una detección paso a paso#
Ejemplo práctico completo: detectar Kerberoasting (T1558.003 en MITRE ATT&CK).
Paso 1: Threat intelligence. Kerberoasting solicita tickets de servicio (TGS) de Active Directory para crackear offline las contraseñas de las cuentas de servicio. La página de la técnica en ATT&CK documenta su uso por numerosos grupos criminales y estatales. La lección de Kerberoasting y AS-REP Roasting la explica desde el lado ofensivo.
Paso 2: Data source. Windows Security Event ID 4769 (A Kerberos service ticket was requested). Campo TicketEncryptionType: 0x17 (RC4) indica downgrade sospechoso (cuentas modernas usan AES).
Paso 3: Regla Sigma.
title: Potential Kerberoasting Activity
logsource:
    product: windows
    service: security
detection:
    selection:
        EventID: 4769
        TicketEncryptionType: '0x17'
        Status: '0x0'
    filter_machine_accounts:
        ServiceName|endswith: '$'
    condition: selection and not filter_machine_accounts
level: high
tags:
    - attack.credential_access
    - attack.t1558.003
falsepositives:
    - Legacy applications requiring RC4
    - Service accounts with RC4 encryption configured
La selección busca tickets concedidos (Status 0x0) con cifrado RC4, y el filtro descarta las cuentas de máquina (terminan en $), que generan tráfico Kerberos legítimo constante. Un error típico es poner la misma condición en la selección y en el filtro: la regla queda sintácticamente válida pero no puede disparar nunca, y sin tests nadie lo nota.
Para convertirla al lenguaje del SIEM se usa sigma-cli:
pip install sigma-cli
sigma plugin install splunk
sigma check rules/windows/kerberoasting.yml
sigma convert -t splunk -p splunk_windows rules/windows/kerberoasting.yml
sigma check valida la regla y sigma convert genera la query para el backend elegido; hay plugins para Elastic, Microsoft Sentinel y otros.
Paso 4: Test. Ejecutar Rubeus kerberoast en lab → verificar que la regla detecta. Ejecutar actividad normal de kerberos → verificar que NO detecta.
Paso 5: Tune. En producción, revisar false positives primera semana. Excluir service accounts legacy documentados. Ajustar filter.
Paso 6: Enrichment. En el SIEM, enriquecer alerta con: asset criticality del target, historial del source user, threat intel match.
Este ciclo aplica a cada detección. Una regla de calidad, con tests positivos y negativos, runbook de triage y falsos positivos documentados, lleva horas de trabajo, no minutos. Por eso hay que priorizar.
Telemetría crítica#
Sin logs correctos, no hay detección posible. Fuentes mandatorias para un SOC moderno:
- Windows: Sysmon (process creation, network, file, registry), Security events, PowerShell ScriptBlock logging.
- Linux: auditd rules, syslog, auth.log, journal.
- Red: Zeek/Suricata logs, DNS query logs, proxy logs con TLS inspection.
- Cloud: AWS CloudTrail, Azure Activity Log, GCP Audit Log.
- Identidad: Azure AD sign-in logs, Okta system log, LDAP audit.
- Email: Exchange/O365 message trace, attachment analysis.
Cada fuente requiere parsing, normalización (ECS/CIM), y storage en SIEM. Log pipeline tools: Logstash, Fluentd, Cribl, Vector.
Errores comunes#
Patterns que degradan calidad del SOC:
- Reglas demasiado amplias:
CommandLine contains 'cmd.exe'genera miles de false positives. - Sin baselining: no conocer qué es normal en tu entorno → todo parece sospechoso.
- Copy-paste sin adaptar: regla de internet sin ajustar a tu entorno específico.
- Sin lifecycle: reglas que nunca se revisan, tunan, o retiran. Una regla que no se ha revisado en 6 meses probablemente ya no refleja el threat landscape actual ni la infraestructura del entorno que protege.
- Detección sin contexto: alerta sin enrichment (usuario, asset criticality, threat intel) es inútil.
- No probar la regla: una condición contradictoria o un nombre de campo mal escrito deja la regla muda para siempre.
- Ignorar data quality: logs incompletos o mal parseados hacen que detecciones perfectamente escritas sean completamente ciegas. Garbage in, garbage out aplica totalmente a detection engineering.
Herramientas del detection engineer#
Stack típico moderno:
- SIEM: Splunk, Elastic Security, Microsoft Sentinel, Chronicle, QRadar.
- EDR: CrowdStrike, Microsoft Defender for Endpoint, SentinelOne, Carbon Black.
- SOAR: Cortex XSOAR, Tines, Shuffle (automatización de response).
- Sigma tooling: pySigma, sigma-cli, SigmaHQ repo.
- YARA tooling: yara-python, YARA-X, yarGen (auto-generate rules).
- Suricata: IDS/IPS + protocol logging.
- Velociraptor: endpoint visibility y response.
- ATT&CK Navigator: visualización de cobertura.
- Atomic Red Team: tests simulados de técnicas ATT&CK.
Rol del detection engineer#
El rol de detection engineer se ha consolidado en los últimos años como especialización separada del analista SOC. Perfil:
Hard skills requeridas:
- Query languages: SPL (Splunk), KQL (Microsoft), EQL (Elastic), YARA-L (Chronicle).
- Programming: Python para automatización, testing, data analysis.
- Sigma/YARA/Suricata rule writing.
- Understanding profundo de MITRE ATT&CK y threat intelligence.
- Sistemas operativos: Windows internals (proceso, registry, ETW), Linux internals (syscalls, auditd).
- Networking: protocolos, packet analysis, Wireshark.
Soft skills:
- Comunicación con analistas SOC (consumidores de tus detecciones).
- Colaboración con threat intelligence (proveedores de contexto).
- Documentación: cada regla necesita runbook de triage.
- Priorización: infinitas técnicas, tiempo finito.
Career path: Analista SOC L2/L3 → Detection Engineer → Staff Detection Engineer → Detection Engineering Manager → Head of Threat Detection.
Lo contratan tanto fabricantes de seguridad (EDR, SIEM, MDR) como equipos internos de bancos, empresas tecnológicas y administraciones públicas.
Preguntas frecuentes#
¿Necesito saber programar?#
Sí. Python para scripting de análisis, automatización de CI/CD pipelines, y data analysis con pandas. Query languages (SPL, KQL, YARA-L) para escribir detecciones en tu SIEM. YAML para Sigma rules. Bash/PowerShell para interacción con endpoints. No necesitas ser developer full-stack pero programming literacy es absolutamente obligatoria para un detection engineer moderno.
¿Cómo empiezo?#
Instala Splunk Free (500MB/día ingesta), configura Sysmon en una VM Windows con config de SwiftOnSecurity, carga logs al Splunk, escribe tus primeras reglas Sigma, convierte a SPL con pySigma, y valida ejecutando técnicas ATT&CK con Atomic Red Team. Todo gratuito y en tu propio equipo.
¿Cuántas reglas necesita un SOC?#
Calidad sobre cantidad. 50 reglas bien tuneadas, con false positive rate controlado y runbooks de triage documentados, superan 5000 reglas default generando noise que quema al equipo. Empieza por las 10 técnicas MITRE más relevantes a tu industria según threat intelligence, y expande gradualmente midiendo cobertura con ATT&CK Navigator.
¿Dónde practico?#
El laboratorio orion-recon de whoami-labs incluye servicios expuestos donde practicas reconnaissance y análisis de logs. Complementa con Blue Team Labs Online y LetsDefend para scenarios SOC completos con alertas reales simuladas.
Resumen#
- Detection engineering: ingeniería de software aplicada a detección de amenazas.
- Sigma: lenguaje universal, portable a cualquier SIEM. 3000+ reglas comunitarias.
- YARA: patrones en archivos y memoria. Estándar para malware classification.
- Suricata: IDS/IPS open-source con protocol parsing profundo.
- Detection-as-Code: Git, CI/CD, unit tests, métricas de calidad.
- Threat hunting: búsqueda proactiva complementando reglas automáticas.
- ATT&CK: framework de priorización basado en threat intelligence relevante al sector y geografía de la organización.
- Career: rol en crecimiento que combina programación, threat intelligence y conocimiento profundo de los sistemas operativos.