Google dorking: cómo usar los operadores de búsqueda para encontrar información expuesta
· 11 min de lectura
Aprende qué es el Google dorking, cómo funcionan los operadores avanzados de búsqueda (site, filetype, inurl, intitle…), cómo se usan en el reconocimiento pasivo de una auditoría autorizada y cómo evitar que tu organización exponga documentos, paneles o credenciales en los buscadores.
Los buscadores recorren internet sin descanso e indexan todo lo que encuentran público: páginas, documentos, listados de carpetas, paneles de administración y, a veces, archivos que nunca debieron publicarse. Con las búsquedas avanzadas puedes pedirle a Google que te muestre exactamente ese tipo de contenido: solo PDF de un dominio, solo páginas con cierta palabra en la URL, solo listados de directorios.
A esa técnica se le llama Google dorking (o Google hacking), y es una de las primeras fases del reconocimiento en una auditoría: permite descubrir información de un objetivo sin tocar sus servidores, solo preguntando al buscador. Para un defensor es igual de útil: buscar tu propio dominio con estos operadores es una forma rápida de descubrir qué estás exponiendo sin saberlo.
En esta lección vas a ver qué son los operadores avanzados, cómo combinarlos, qué tipo de información se encuentra con ellos, cómo se usan dentro de una auditoría autorizada y cómo proteger a tu organización.
Usa estas búsquedas sobre dominios propios o dentro del alcance de una auditoría autorizada. Acceder a información o sistemas ajenos que encuentres en un buscador, aunque estén indexados, puede ser un delito.
Qué es el Google dorking#
Un dork es una consulta de búsqueda que usa operadores especiales para filtrar resultados con mucha precisión. En lugar de buscar «manual de empleados», puedes buscar documentos PDF de un dominio concreto que contengan la palabra «confidencial» en el título.

El Google dorking forma parte del reconocimiento pasivo u OSINT (Open Source Intelligence, inteligencia de fuentes abiertas): obtener información de fuentes públicas sin interactuar directamente con los sistemas del objetivo. Como no se envía ningún paquete a sus servidores, el objetivo no puede detectarlo.
Los operadores principales#
| Operador | Qué hace | Ejemplo |
|---|---|---|
site: | Limita los resultados a un dominio o subdominio | site:ejemplo.com |
filetype: o ext: | Busca un tipo de archivo | filetype:pdf |
inurl: | La palabra debe aparecer en la URL | inurl:admin |
intitle: | La palabra debe aparecer en el título de la página | intitle:"index of" |
intext: | La palabra debe aparecer en el texto | intext:"contraseña" |
"..." | Busca la frase exacta | "uso interno" |
- | Excluye un término o un sitio | site:ejemplo.com -www |
OR | Una u otra condición | filetype:xls OR filetype:xlsx |
* | Comodín para una o varias palabras | "informe * confidencial" |
Los operadores se pueden combinar libremente, y ahí está su potencia. Google cambia de vez en cuando qué operadores admite y con qué precisión, así que conviene comprobar los resultados en lugar de dar por hecho que un operador funciona siempre igual.
Cómo se combinan#
site:ejemplo.com filetype:pdf "confidencial"Documentos PDF de ese dominio que contienen la palabra «confidencial».
site:ejemplo.com -site:www.ejemplo.comResultados de cualquier subdominio excepto www: una forma pasiva de descubrir subdominios que quizá no conocías, como entornos de pruebas o paneles internos.
site:ejemplo.com intitle:"index of"Carpetas del servidor con el listado de directorios activado, donde se ven todos los archivos que contienen.
site:ejemplo.com (inurl:login OR inurl:admin OR intitle:"panel")Páginas de inicio de sesión y paneles de administración publicados.
site:ejemplo.com (ext:sql OR ext:bak OR ext:log OR ext:env)Copias de seguridad, volcados de bases de datos, registros o archivos de configuración que nunca debieron indexarse.
Qué información se suele encontrar#
| Tipo de hallazgo | Por qué es un riesgo |
|---|---|
| Documentos internos (PDF, Word, Excel) | Nombres, cargos, correos y datos para ingeniería social |
| Metadatos de documentos | Nombres de usuario, versiones de software, rutas internas |
| Listados de directorios | Acceso a todos los archivos de una carpeta |
Archivos de configuración y .env | Contraseñas de bases de datos y claves de API |
| Copias de seguridad y volcados SQL | Toda la información de una aplicación |
| Paneles de administración y logins | Puntos de entrada para ataques de credenciales |
| Mensajes de error | Rutas del servidor, versiones y tecnologías usadas |
| Subdominios olvidados | Entornos de prueba menos protegidos que producción |
La Google Hacking Database#
La Google Hacking Database (GHDB), mantenida por Exploit-DB, es una colección pública de miles de dorks organizados por categorías: archivos con contraseñas, páginas de login, dispositivos conectados, mensajes de error, servidores vulnerables… Es una referencia útil para aprender cómo se construyen buenas consultas y para revisar tu propio dominio con búsquedas que ya han demostrado encontrar problemas reales.
Cómo se usa en una auditoría autorizada#
El dorking encaja en la primera fase de una prueba de penetración: el reconocimiento. Un flujo ordenado, siempre dentro del alcance acordado con el cliente, sería:
Paso 1: definir el alcance#
Anota los dominios y subdominios autorizados. Todo lo que encuentres fuera de ese alcance se documenta pero no se toca.
Paso 2: descubrir subdominios#
site:ejemplo.com -site:www.ejemplo.comRepite excluyendo los subdominios que ya conoces (-site:blog.ejemplo.com) para que aparezcan los nuevos.
Paso 3: buscar documentos y metadatos#
site:ejemplo.com (filetype:pdf OR filetype:docx OR filetype:xlsx)Descarga los documentos permitidos y revisa sus metadatos con herramientas como exiftool: el autor, el programa que los creó y a veces rutas internas o nombres de usuario.
exiftool informe_anual.pdfPaso 4: buscar exposiciones#
Prueba las combinaciones de archivos sensibles, listados de directorios, paneles y mensajes de error sobre los dominios del alcance.
Paso 5: documentar#
Para cada hallazgo, guarda la consulta usada, la URL, la fecha y una captura. En el informe, los hallazgos de esta fase suelen ser de los más fáciles de corregir y de los que más impacto evitan.
Otros buscadores útiles#
Google no es la única fuente. En el reconocimiento también se usan:
| Fuente | Qué aporta |
|---|---|
| Bing y DuckDuckGo | Índices distintos; a veces muestran lo que Google no |
| Shodan y Censys | Buscan dispositivos y servicios expuestos a internet, no páginas |
| Wayback Machine | Versiones antiguas de las páginas y archivos ya retirados |
| GitHub | Código público que puede contener credenciales o rutas internas |
| Certificados (crt.sh) | Subdominios que aparecen en certificados TLS emitidos |
Lista de revisión para tu propio dominio#
Si administras una web, estas búsquedas sobre tu dominio son un buen punto de partida para una revisión rápida. Sustituye tudominio.com por el tuyo y revisa cada resultado:
| Búsqueda | Qué estás comprobando |
|---|---|
site:tudominio.com -site:www.tudominio.com | Subdominios indexados que quizá ya no usas |
site:tudominio.com intitle:"index of" | Carpetas con el listado de archivos activado |
site:tudominio.com (ext:env OR ext:sql OR ext:bak OR ext:log) | Configuraciones, copias y registros expuestos |
site:tudominio.com (filetype:pdf OR filetype:xlsx) "confidencial" | Documentos internos publicados por error |
site:tudominio.com (inurl:admin OR inurl:login OR inurl:wp-admin) | Paneles de administración visibles para todo el mundo |
site:tudominio.com intext:"error" intext:"sql" | Mensajes de error que revelan detalles técnicos |
site:github.com "tudominio.com" | Código público que menciona tu dominio y podría incluir credenciales |
Si una búsqueda no devuelve nada, no significa que no haya problema: puede que el buscador aún no lo haya indexado. Por eso conviene repetir la revisión cada cierto tiempo y combinarla con una revisión directa del servidor.
Shodan: el buscador de dispositivos#
Mientras Google indexa páginas, Shodan indexa dispositivos y servicios conectados a internet: servidores, cámaras, routers, bases de datos, sistemas industriales. Para cada dirección IP guarda los puertos abiertos y la información que devuelve cada servicio al conectarse, como la versión del software.
Con filtros como hostname:tudominio.com, org:"Nombre de la empresa" o port:3306, una organización puede ver qué servicios suyos están expuestos a internet: una base de datos accesible desde fuera, un panel de una cámara o un servicio con una versión antigua. Para un defensor es una forma excelente de ver su infraestructura como la ve un atacante, y de detectar servicios que nunca debieron publicarse. Censys ofrece un servicio parecido, y ambos tienen planes gratuitos con búsquedas limitadas, suficientes para revisar los activos de una organización pequeña.
Cómo proteger a tu organización#
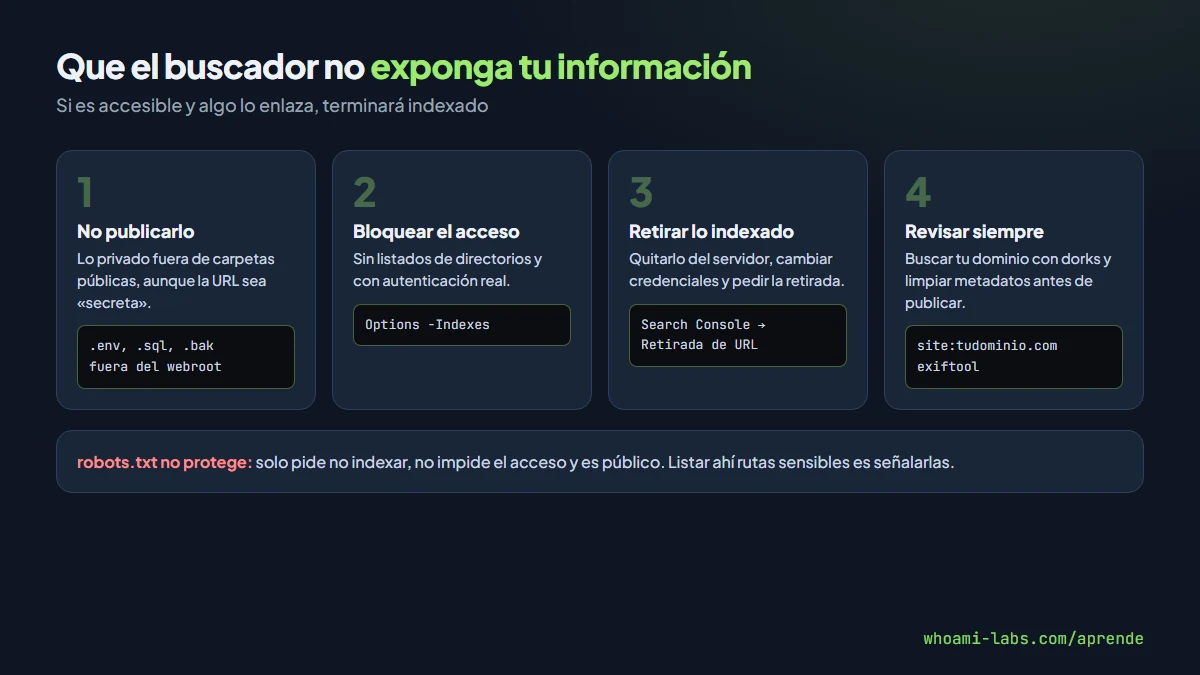
No publicar lo que no debe ser público#
La regla principal: si un archivo no debe ser público, no debe estar en una carpeta pública, aunque nadie conozca su URL. Los buscadores lo encontrarán por enlaces, listados de directorios o sitemaps.
Desactivar el listado de directorios#
En Apache, por ejemplo:
Options -IndexesProteger con autenticación, no con robots.txt#
El archivo robots.txt le pide a los buscadores que no indexen ciertas rutas, pero no impide el acceso y además es público: listar en él tus rutas sensibles es señalarlas. Para impedir el acceso hace falta autenticación o bloquearlo en el servidor. Para evitar que una página pública se indexe, usa la etiqueta o cabecera noindex.
Retirar lo que ya está indexado#
Si encuentras información sensible indexada: primero quítala del servidor (o protégela), cambia cualquier credencial expuesta y después solicita su retirada en Google Search Console con la herramienta de retirada de URL.
Revisar periódicamente#
Incluye en tu rutina de seguridad las mismas búsquedas que haría un atacante sobre tus dominios, y limpia los metadatos de los documentos antes de publicarlos.
Errores comunes#
- Confiar en la «seguridad por oscuridad». Una URL difícil no protege un archivo público.
- Usar robots.txt para ocultar rutas sensibles. Es público y es lo primero que mira un auditor.
- Retirar un archivo del buscador pero no del servidor. Sigue accesible para quien tenga la URL.
- Olvidar las credenciales expuestas. Si un
.envestuvo indexado, hay que cambiar todas sus claves, no solo borrarlo. - Salirse del alcance. En una auditoría, encontrar algo de otro dominio no autoriza a investigarlo.
Preguntas frecuentes#
¿Es legal hacer Google dorking?#
Buscar en Google es legal. Lo que puede no serlo es acceder y usar la información o los sistemas que encuentres sin autorización. En una auditoría, todo debe estar dentro del alcance acordado.
¿Por qué Google indexa archivos que deberían ser privados?#
Porque están en una ubicación pública y algo los enlaza, o porque el servidor muestra el listado de la carpeta. El buscador no sabe que eran privados: indexa lo que es accesible.
¿Sirve robots.txt para proteger información?#
No. Solo pide a los buscadores que no indexen, no impide el acceso, y es un archivo público que cualquiera puede leer.
¿Qué es el reconocimiento pasivo?#
Recopilar información de un objetivo sin interactuar directamente con sus sistemas, usando fuentes públicas como buscadores, redes sociales, registros DNS o certificados.
¿Qué hago si encuentro por casualidad información expuesta de otra organización?#
No la descargues, no la uses y no compartas la URL públicamente. Lo responsable es avisar a la organización por un canal oficial: muchas tienen un archivo security.txt en su web, un correo de seguridad o un programa de divulgación de vulnerabilidades. Explica qué encontraste y cómo, sin acceder más allá de lo imprescindible para describirlo. Este proceso se conoce como divulgación responsable (en inglés responsible disclosure) y protege tanto a la organización como a ti de problemas legales.
¿Cómo practico?#
Sobre tu propio dominio o tu propia web, y en los laboratorios de whoami-labs enlazados al final de esta lección, donde la información pública (OSINT) forma parte del camino.
Resumen#
- El Google dorking usa operadores avanzados (
site:,filetype:,inurl:,intitle:,intext:) para encontrar información muy concreta. - Es una técnica de reconocimiento pasivo: no toca los servidores del objetivo.
- Revela documentos, metadatos, listados de directorios, configuraciones, copias de seguridad y paneles expuestos.
- En una auditoría se usa dentro del alcance, documentando cada hallazgo.
- Se previene no publicando lo privado, desactivando listados, protegiendo con autenticación (no con robots.txt), retirando lo indexado y revisando periódicamente.