ASLR bypass moderno: info leaks, partial overwrites y brute force
· 10 min de lectura
ASLR randomiza direcciones de código y datos para dificultar exploitation. Aprende cómo funciona, sus limitaciones arquitecturales, y las técnicas que attackers usan para bypassearlo: info leaks, partial overwrites, return-to-plt, brute force, y side-channel attacks.
ASLR (Address Space Layout Randomization) es la mitigación más importante contra memory corruption exploits. Randomiza las direcciones base de stack, heap, librerías compartidas, y el ejecutable principal (PIE), de modo que un atacante no puede predecir dónde están los gadgets ROP, las funciones de libc, o las estructuras de datos que necesita corromper.
Sin embargo, ASLR no es invencible. Sus limitaciones arquitecturales (entropía finita, granularidad de página, información residual en memoria) permiten bypasses que researchers explotan consistentemente. Esta lección cubre cómo funciona ASLR, sus variantes por plataforma, y las técnicas de bypass más usadas en CTFs y exploits reales. Es la undécima lección de la Tanda 7.
ASLR bypass es técnica de exploitation. Usar sólo en CTFs, bug bounties, o engagements autorizados.
Cómo funciona ASLR#
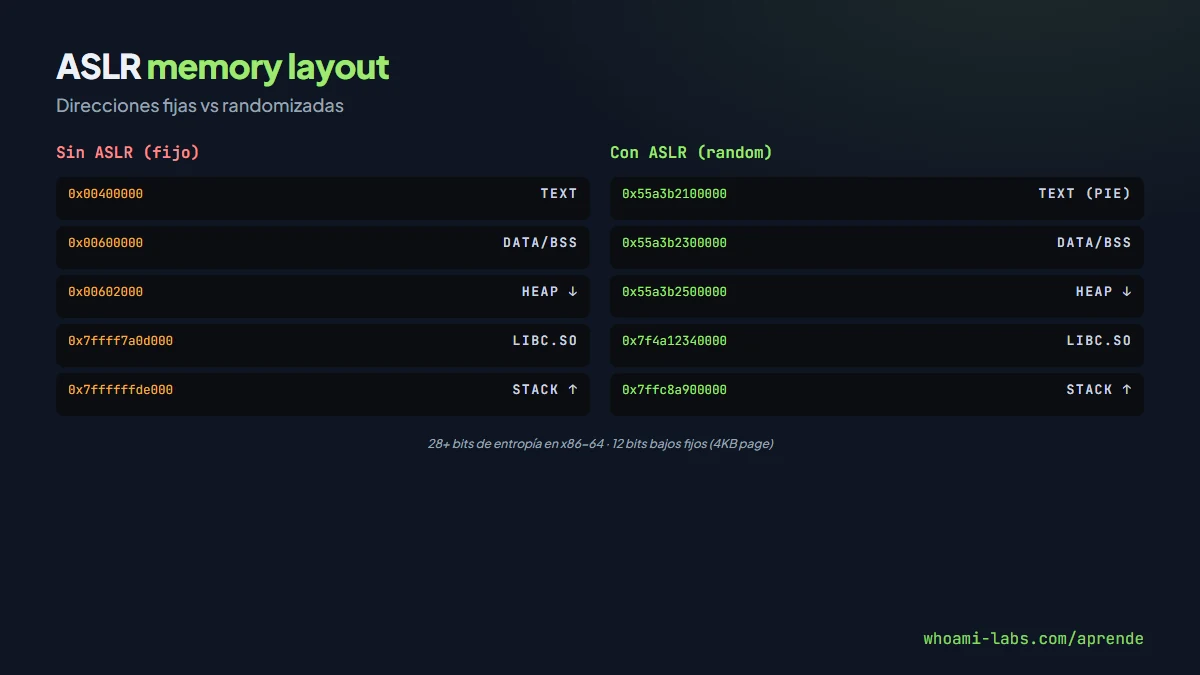
Sin ASLR, el layout de memoria de un proceso es predecible:
0x400000        Texto (código ejecutable)
0x600000        Data/BSS
0x7ffff7...     libc.so
0x7ffffffd...   Stack
Con ASLR, cada región tiene una base aleatoria diferente en cada ejecución:
0x55a3b2100000  Texto (PIE)
0x55a3b2300000  Heap
0x7f4a12340000  libc.so
0x7ffc8a900000  Stack
Entropía por plataforma#
La cantidad de bits aleatorios varía:
- Linux x86-64: ~28 bits para mmap/libraries, ~30 bits para stack, ~28 bits para heap, ~28 bits para PIE.
- Linux x86 (32-bit): ~8 bits para libraries (solo 256 posiciones). Brute-forceable en segundos.
- Windows 10/11: ~17-24 bits dependiendo de región. ASLR mejorado con High Entropy ASLR.
- macOS: similar a Linux 64-bit. Reforzado en Apple Silicon.
- Android: ~24 bits para libraries en ARM64.
Granularidad de página#
ASLR opera a nivel de páginas de 4KB (0x1000). Esto significa que los 12 bits bajos de cualquier dirección son siempre conocidos. Un puntero a libc_base + 0x45AB0 siempre termina en 0xAB0. Esto habilita partial overwrites.
PIE (Position Independent Executable)#
Ejecutables compilados con -fPIE -pie tienen su base randomizada. Sin PIE, el .text está en dirección fija (típicamente 0x400000 en Linux x86-64) → gadgets conocidos sin leak.
Técnicas de bypass#
Info leak (la más común)#
Obtener una dirección de memoria del proceso, calcular el offset a la base, derivar todas las demás direcciones. Fuentes de leaks:
Format string vulnerability:
printf(user_input);  // %p%p%p leak stack pointers
// Output: 0x7ffc12345678 0x55a3b2100abc 0x7f4a1234def0
// → stack address, PIE address, libc address
UAF read: Chunk liberado en unsorted bin tiene punteros fd/bk a main_arena en libc. Leer esos punteros = libc leak directo.
Uninitialized memory: Buffer no inicializado puede contener residuos de operaciones anteriores: punteros de stack, heap, libc.
Partial read overflow: Leer más bytes de los esperados revela punteros adyacentes en memoria.
Error messages: Algunos programas imprimen direcciones en mensajes de error (stack traces, assertion failures, debug output).
procfs (/proc/self/maps): Si el atacante puede leer este archivo, tiene el layout completo. Relevante en some LFI web vulns.
Partial overwrite#
Sobrescribir solo los bytes bajos de un puntero, preservando los bits aleatorizados. Como ASLR no afecta los 12 bits bajos (granularidad de página), cambiar solo el último byte o los últimos dos bytes de un puntero es determinístico o tiene entropía muy reducida (4 bits para 1.5 bytes).
Puntero original:  0x7f4a 1234 5AB0
Partial overwrite:  0x7f4a 1234 5XX0  ← solo cambias XX
                                        (12 bits fijos, 4 bits random)
Esto permite redirigir a funciones cercanas en la misma página o región de libc sin necesitar leak completo. Probabilidad de éxito: 1/16 para 4 bits de entropía.
Brute force#
En 32 bits, ASLR de libraries tiene solo ~8 bits de entropía → 256 intentos. Un fork server que no re-randomiza entre connections (ej: Apache pre-fork) permite brute force en segundos.
En 64 bits, brute force directo es impractical para la mayoría de regiones (~28 bits = 268 millones de intentos). Pero combinado con partial overwrites (reducir a 4-12 bits) se vuelve viable.
Return-to-PLT / Return-to-GOT#
Si el ejecutable NO es PIE (base fija), la PLT (Procedure Linkage Table) y GOT (Global Offset Table) están en direcciones conocidas. PLT contiene stubs que saltan a funciones de libc → usables sin leak de libc.
ROP chain: pop rdi; ret → "/bin/sh" → PLT[system]GOT leak: si puedes leer la GOT, obtienes la dirección resuelta de funciones libc → libc base calculable.
ret2dlresolve#
Técnica avanzada: construir un fake relocation entry que fuerza al dynamic linker a resolver una función arbitraria (ej: system) y saltar a ella. No requiere leak de libc ni PIE off. Complejo pero poderoso.
Side-channel attacks#
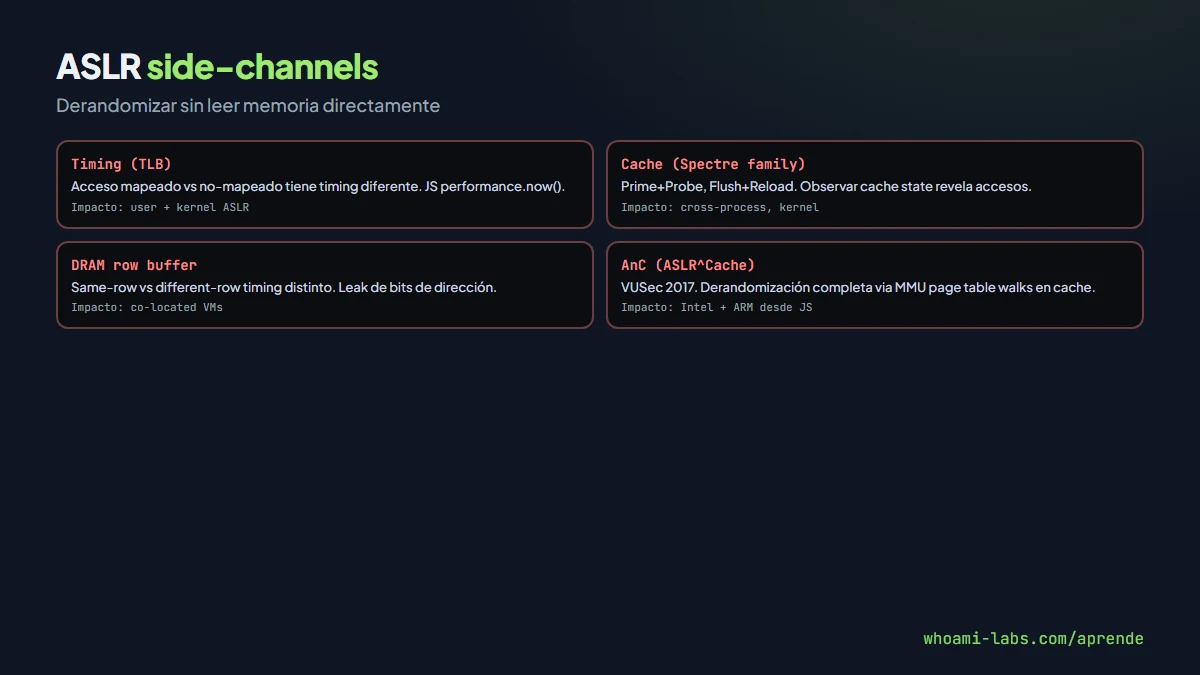
Ataques que infieren direcciones sin leerlas directamente:
Timing attacks: Acceso a dirección mapeada vs no-mapeada tiene timing diferente (TLB hit vs fault). JavaScript en browsers usó performance.now() para derandomizar ASLR de kernel (KASLR).
Cache side-channels: Spectre/Meltdown family. Observar cache state revela si una dirección fue accedida. Prime+Probe, Flush+Reload.
DRAM row buffer: Acceso a misma row vs diferente row tiene timing distinto → leak de bits de dirección.
MMU side-channels: Page table walks observables via timing. Investigación activa en derrandomizar ASLR de kernel y procesos vecinos.
AnC (ASLR^Cache): Ataque publicado por VUSec (2017) que derandomiza ASLR completamente via cache side-channels desde JavaScript. Funciona en Intel y ARM.
Ret2dlresolve en detalle#
Esta técnica merece profundización por su poder: funciona sin leak, con PIE, con full ASLR. El dynamic linker resuelve funciones lazily (primera llamada). El atacante construye en el stack o heap:
- Un fake Elf64_Rel relocation entry apuntando a un fake symbol.
- Un fake Elf64_Sym symbol entry con nombre apuntando a string "system".
- Un fake string table entry con "system\0".
- ROP chain que llama a
_dl_runtime_resolve()con index del fake relocation.
El linker resuelve "system" legitimamente, obtiene la dirección real de system() en libc, y salta ahí con argumento controlado (ej: "/bin/sh"). Ningún leak necesario.
Herramientas como pwntools automatizan la construcción con Ret2dlresolvePayload(). Complejidad alta pero es la técnica "universal" contra ASLR en binarios ELF sin leak disponible.
Limitaciones: requiere control de stack suficiente para los fake entries (~200 bytes), y binario debe usar lazy binding (default). RELRO full (Relocation Read-Only) bloquea esta técnica porque GOT es de solo lectura.
Combinación de técnicas en exploits reales#
Un exploit del mundo real rara vez usa una sola técnica. Cadena típica contra binary con ASLR + PIE + NX:
- Partial overwrite del return address para redirigir a un gadget en la misma página → info leak primitiva.
- Info leak de libc address via puts/write sobre GOT entry → calcular libc base.
- Second stage: ROP chain completa usando gadgets de libc con direcciones calculadas.
- system("/bin/sh") o
execvepara shell.
Contra ASLR + PIE + NX + Full RELRO + Stack canary:
- Canary leak via format string o over-read.
- PIE leak via same technique.
- Libc leak via PLT calls revelando GOT.
- ROP chain sobre libc.
Cada mitigación adicional añade un paso al exploit pero no lo previene si hay primitivas suficientes. La defensa real es eliminar los bugs de memoria, no confiar en mitigaciones.
KASLR (Kernel ASLR)#
Linux kernel randomiza su base address desde 3.14. Entropía: ~9 bits x86-64 (512 posiciones). Limitaciones:
- Kernel tiene muchas info leaks:
/proc/kallsyms(requierekptr_restrict), dmesg, timing side-channels. - KASLR es base-only: offsets internos son fijos. Un leak de cualquier símbolo del kernel → toda la simbología deducible.
- Spectre v1/v2 bypassa KASLR trivialmente en hardware vulnerable (pre-mitigación).
- kPTI (kernel page table isolation) mitiga Meltdown pero no todos los side-channels.
ASLR en browsers#
Browsers son target principal de exploitation y tienen ASLR challenges propios:
- V8 (Chrome): heap sandbox, compressed pointers (4GB cage), PartitionAlloc. Leaks dentro del sandbox no revelan direcciones fuera de él.
- SpiderMonkey (Firefox): jemalloc compartido. Info leaks via JIT compiled code.
- JavaScriptCore (Safari): Gigacage para typed arrays. PAC (Pointer Authentication) en Apple Silicon.
Browsers han reducido precisión de timers (performance.now() granularidad degradada, SharedArrayBuffer restrictions post-Spectre) para dificultar timing side-channels.
Estado del arte 2025#
Tendencias actuales en ASLR y bypasses:
- CET (Control-flow Enforcement Technology): shadow stack + indirect branch tracking. No afecta ASLR directamente pero reduce utilidad de gadgets ROP.
- PAC (Pointer Authentication, ARM): firma criptográfica en punteros. Corromper puntero sin key correcta → crash. Apple Silicon usa PAC extensivamente.
- CFI (Control Flow Integrity): validates indirect call targets. Reduce gadgets útiles.
- MTE (Memory Tagging Extension, ARM): tag en cada granule de memoria. UAF y overflow detectados probabilistically (1/16 por tag).
- Researcher response: cada mitigación genera investigación de bypass en meses. PAC bypass demostrado (PACMAN, 2022). MTE bypass teórico publicado. CET bypasses via JOP.
La tendencia es que ASLR solo no basta. Stack de mitigaciones (ASLR + CFI + PAC + MTE + sandbox) aumenta coste de exploitation pero no lo elimina. Nation-state attackers siguen encontrando full chains.
Preguntas frecuentes#
¿ASLR afecta performance?#
Mínimamente. El overhead es casi cero en runtime. PIE añade un tiny overhead por indirección relativa, pero negligible en hardware moderno.
¿Debo compilar siempre con PIE?#
Sí. Todas las distribuciones Linux modernas compilan con PIE por defecto. Sin PIE, ASLR del texto es nula y gadgets ROP son gratis para el atacante.
¿Format strings aún existen en código real?#
Sí, sorprendentemente. Compiladores modernos advierten con -Wformat-security pero código legacy, embedded, firmware IoT, y proyectos mal mantenidos los tienen. Bug bounties siguen pagando por ellas. En 2024 se publicaron CVEs de format string en software comercial de networking y sistemas SCADA industriales.
¿Qué pasa con lenguajes memory-safe?#
Rust, Go, Java, C# eliminan la mayoría de bugs de memoria por diseño. Código escrito en estos lenguajes no es vulnerable a ASLR bypass porque no tiene los bugs de corrupción de memoria que ASLR protege. Sin embargo, bindings FFI a C/C++, unsafe blocks en Rust, y JNI en Java reintroducen el riesgo. La transición de la industria a memory-safe languages es la defensa definitiva a largo plazo, pero tardará décadas en cubrir todo el código legacy existente.
¿Cuánta entropía es suficiente?#
Depende del threat model. 28 bits (Linux x86-64 mmap) requiere ~134 millones de intentos para brute force directo — impractical para un exploit remoto sin fork server. Pero side-channels reducen esa entropía significativamente. ARM MTE + PAC añaden defensa en profundidad independiente de entropía ASLR.
¿Dónde practico?#
El laboratorio orion-recon de whoami-labs entrena reconocimiento y análisis de servicios. Para ASLR bypass específico, complementa con CTF platforms (pwnable.tw, pwnable.kr) que tienen challenges binarios donde practicas info leaks y partial overwrites en sandbox controlado.
Resumen#
- ASLR: randomiza base de stack, heap, libraries, PIE. 28+ bits en x86-64.
- Granularidad: 4KB páginas. 12 bits bajos siempre conocidos → partial overwrites viables.
- Info leaks: format string, UAF read, uninitialized memory, procfs, error messages. Técnica #1 de bypass más utilizada.
- Partial overwrite: cambiar solo bytes bajos de puntero. 4-12 bits de entropía.
- Brute force: viable en 32 bits (solo 256 intentos) o combinado con partial overwrite en 64 bits.
- Side-channels: timing, cache (Spectre family), DRAM. Derandomización sin leak directo.
- Futuro: PAC (Pointer Authentication), MTE (Memory Tagging), CET (Control-flow Enforcement) complementan ASLR. Cada uno genera investigación activa de bypass por parte de la comunidad de security researchers.