Arquitectura web y HTTP: qué es, cómo funciona y cómo se aplica al pentesting
· 15 min de lectura
Entiende cómo funciona la web por dentro: peticiones HTTP, cookies, sesiones, CORS, proxies y CDN. Todo lo que un pentester necesita saber antes de tocar Burp Suite.
Antes de lanzar Burp Suite, antes de escribir un payload de XSS y antes de buscar un IDOR, necesitas entender cómo funciona la web. No de forma superficial, sino con la profundidad suficiente para saber qué estás interceptando, por qué el servidor responde como responde y qué significan las cabeceras que ves en cada petición.
La mayoría de los fallos web que explotan los pentesters existen porque alguien no entendió bien cómo funciona HTTP, cómo se gestionan las cookies o qué implica la Same-Origin Policy. Esta lección cubre los fundamentos que necesitas dominar para que el resto de las lecciones de explotación web tengan sentido completo. Los laboratorios server-vault y doorkick de whoami-labs ponen en práctica varios de estos conceptos.
Todo lo que se explica aquí es para que entiendas cómo funciona la tecnología y puedas auditar sistemas con autorización. Manipular peticiones HTTP, cookies o cabeceras de sitios ajenos sin permiso es un delito en la mayoría de legislaciones.
Qué es el protocolo HTTP#
HTTP (HyperText Transfer Protocol) es el protocolo de capa de aplicación que gobierna la comunicación entre navegadores (clientes) y servidores web. Funciona sobre TCP (o sobre QUIC en HTTP/3) y sigue un modelo de petición-respuesta: el cliente envía una petición, el servidor la procesa y devuelve una respuesta. No hay memoria entre peticiones: HTTP es sin estado (stateless) por diseño.
Esa ausencia de estado es precisamente lo que obliga a inventar mecanismos como las cookies y los tokens de sesión. Cada petición HTTP llega al servidor como si fuera la primera, así que el servidor necesita alguna forma de saber quién la envía. Ahí empiezan muchos de los problemas de seguridad que verás en otras lecciones.
HTTPS y TLS#
HTTPS es HTTP sobre TLS (Transport Layer Security). El protocolo HTTP en sí no cambia; lo que cambia es que el canal está cifrado. TLS protege la confidencialidad e integridad de los datos en tránsito, pero no protege contra vulnerabilidades en la lógica de la aplicación. Un XSS almacenado funciona igual con HTTP que con HTTPS.
Para un pentester, la diferencia práctica es que necesitas un proxy como Burp Suite que actúe como intermediario TLS (man-in-the-middle autorizado) para ver el tráfico en claro.
Estructura de una petición HTTP#
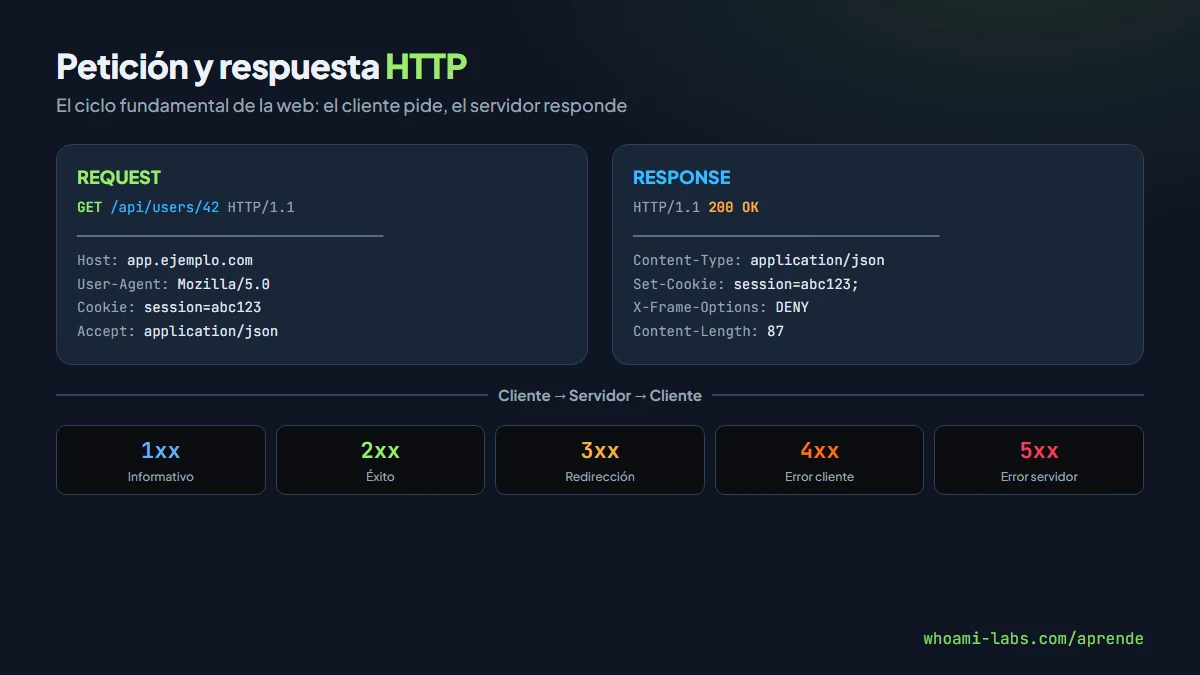
Una petición HTTP tiene tres partes: línea de petición, cabeceras y cuerpo (opcional).
GET /api/users/42 HTTP/1.1
Host: app.ejemplo.com
User-Agent: Mozilla/5.0
Accept: application/json
Cookie: session=abc123def456
La línea de petición indica el método (GET), la ruta (/api/users/42) y la versión del protocolo. Las cabeceras son pares clave-valor que añaden contexto. El cuerpo aparece en métodos como POST o PUT, separado de las cabeceras por una línea en blanco.
Métodos HTTP principales#
| Método | Propósito | Cuerpo habitual |
|---|---|---|
| GET | Obtener un recurso | No |
| POST | Enviar datos al servidor | Sí |
| PUT | Reemplazar un recurso completo | Sí |
| PATCH | Modificar parcialmente un recurso | Sí |
| DELETE | Eliminar un recurso | Opcional |
| OPTIONS | Consultar métodos permitidos y CORS | No |
| HEAD | Igual que GET pero sin cuerpo de respuesta | No |
En pentesting, los métodos poco comunes son interesantes. Un servidor que acepta PUT o DELETE sin autenticación permite sobrescribir o borrar recursos. El laboratorio server-vault expone un IIS con WebDAV donde los métodos HTTP permisivos son el vector de entrada.
Estructura de una respuesta HTTP#
HTTP/1.1 200 OK
Content-Type: application/json; charset=utf-8
Set-Cookie: session=abc123def456; HttpOnly; Secure; SameSite=Lax
X-Frame-Options: DENY
Content-Length: 87

{"id":42,"name":"Carlos","role":"admin"}
La línea de estado indica la versión del protocolo, el código de estado (200) y una frase descriptiva (OK). Los códigos de estado se agrupan en cinco familias:
| Rango | Significado | Ejemplo relevante para pentesting |
|---|---|---|
| 1xx | Informativo | 101 Switching Protocols (WebSocket) |
| 2xx | Éxito | 200 OK, 201 Created |
| 3xx | Redirección | 301, 302 (open redirect si no se valida) |
| 4xx | Error del cliente | 401 Unauthorized, 403 Forbidden, 404 Not Found |
| 5xx | Error del servidor | 500 Internal Server Error (puede filtrar información) |
Un 403 frente a un 404 ya te dice algo: el recurso existe pero no tienes permiso. Un 500 con un stack trace es una fuga de información directa. Interpretar los códigos es parte del reconocimiento.
Cabeceras importantes para seguridad#
Algunas cabeceras tienen impacto directo en la seguridad de la aplicación:
| Cabecera | Función de seguridad |
|---|---|
| Content-Security-Policy | Define qué orígenes pueden cargar scripts, estilos, imágenes |
| Strict-Transport-Security | Fuerza HTTPS durante un tiempo definido (HSTS) |
| X-Content-Type-Options | Con nosniff, evita que el navegador adivine el MIME type |
| X-Frame-Options | Controla si la página puede cargarse en un iframe (anti-clickjacking) |
| Referrer-Policy | Controla qué información se envía en la cabecera Referer |
| Permissions-Policy | Restringe el acceso a APIs del navegador (cámara, GPS, micrófono) |
La ausencia de estas cabeceras es un hallazgo habitual en auditorías. No son vulnerabilidades críticas por sí solas, pero amplían la superficie de ataque.
HTTP/1.1, HTTP/2 y HTTP/3#
| Aspecto | HTTP/1.1 | HTTP/2 | HTTP/3 |
|---|---|---|---|
| Transporte | TCP | TCP con TLS | QUIC (UDP con TLS integrado) |
| Multiplexación | No (una petición por conexión o pipelining limitado) | Sí (múltiples streams en una conexión) | Sí, sin bloqueo head-of-line |
| Compresión de cabeceras | No | HPACK | QPACK |
| Server Push | No | Sí (en desuso) | Sí (en desuso) |
Para el pentester, HTTP/2 introdujo complejidades nuevas. Las herramientas deben soportar la multiplexación binaria, y ataques como HTTP request smuggling tienen variantes específicas para HTTP/2 (como los documentados por James Kettle en PortSwigger). HTTP/3 sobre QUIC añade otra capa: el cifrado es obligatorio desde el handshake inicial, y las herramientas de interceptación necesitan soporte explícito.
En la práctica, Burp Suite maneja HTTP/2 de forma transparente desde la versión 2022. Para HTTP/3 la cobertura de herramientas es todavía limitada.
Cookies y gestión de sesiones#
HTTP es sin estado, así que para mantener una sesión (saber que el usuario ya se autenticó) se usan cookies de sesión. El servidor envía una cabecera Set-Cookie y el navegador la devuelve en cada petición posterior al mismo dominio.
Set-Cookie: session=eyJhbGciOiJIUzI1NiJ9...; Path=/; HttpOnly; Secure; SameSite=Lax; Max-Age=3600Atributos de seguridad de las cookies#
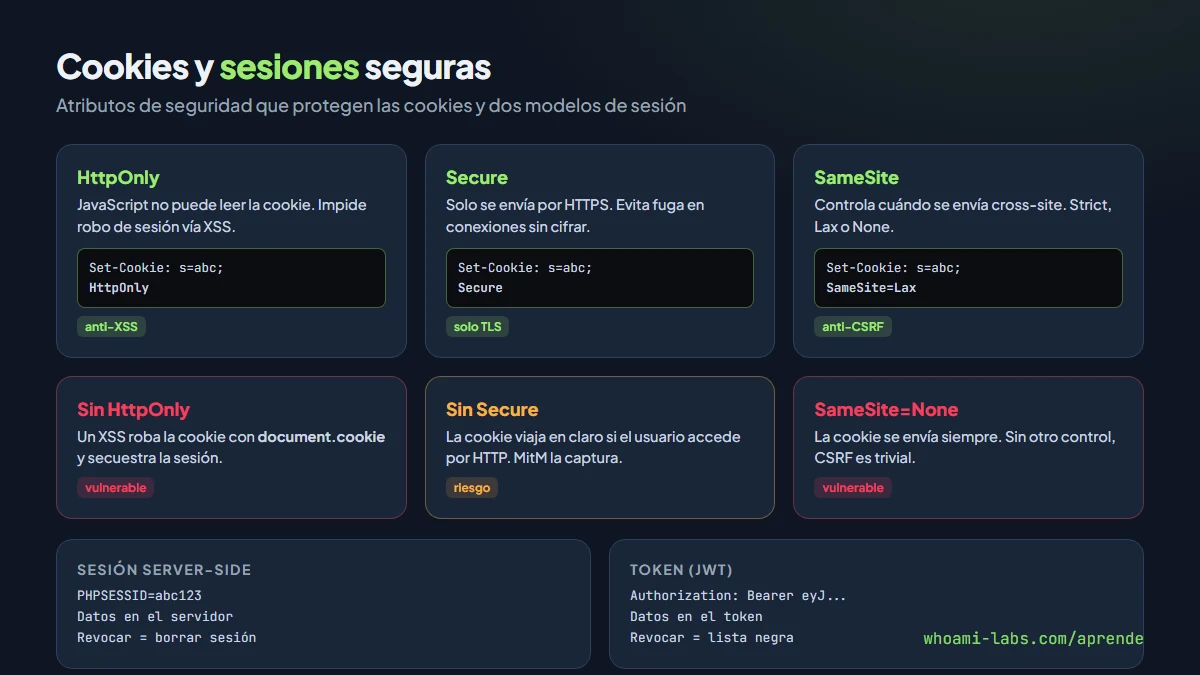
| Atributo | Efecto | Si falta |
|---|---|---|
| HttpOnly | El JavaScript no puede acceder a la cookie via document.cookie | Un XSS roba la cookie de sesión |
| Secure | La cookie solo se envía por HTTPS | Se filtra en conexiones sin cifrar |
| SameSite=Strict | No se envía en ninguna petición cross-site | Protege contra CSRF |
| SameSite=Lax | Se envía en navegaciones top-level pero no en peticiones embebidas | Protección parcial contra CSRF |
| SameSite=None | Se envía siempre (requiere Secure) | Vulnerable a CSRF si no hay otro control |
| Domain | Define a qué dominios se envía | Solo al dominio exacto |
| Path | Restringe la cookie a una ruta | Se envía a todo el dominio |
Un error clásico es configurar la cookie de sesión sin HttpOnly. Si la aplicación tiene un XSS, el atacante puede robar la cookie con un simple acceso a document.cookie. Otro error frecuente es no poner Secure, lo que permite que la cookie viaje en claro si el usuario accede por HTTP.
Sesiones server-side vs tokens#
Hay dos modelos dominantes:
Sesión server-side: el servidor almacena los datos de sesión (usuario, permisos) en memoria o base de datos, y le da al cliente un identificador opaco (como PHPSESSID=abc123). El cliente solo tiene el ID; los datos reales están en el servidor.
Token (JWT, por ejemplo): el servidor firma un token que contiene los datos de sesión y se lo da al cliente. El cliente lo envía en cada petición (generalmente en la cabecera Authorization). El servidor no guarda estado: verifica la firma y lee los datos del token.
Cada modelo tiene implicaciones distintas para el pentesting. Con sesiones server-side, el objetivo es robar o adivinar el session ID. Con JWT, el objetivo es manipular el token (cambiar el algoritmo a none, crackear la clave de firma, explotar confusión de algoritmos RS256/HS256).
Same-Origin Policy y CORS#
La Same-Origin Policy (SOP) es la regla fundamental del navegador: un script cargado desde un origen (protocolo + dominio + puerto) no puede leer la respuesta de otro origen. Esto impide que un sitio malicioso lea tus datos de otro sitio donde estás autenticado.
Dos URLs tienen el mismo origen solo si coinciden en protocolo, dominio y puerto:
https://app.ejemplo.com:443/ruta  -->  mismo origen
https://app.ejemplo.com:443/otra  -->  mismo origen
http://app.ejemplo.com:443/ruta   -->  distinto (http vs https)
https://api.ejemplo.com:443/ruta  -->  distinto (subdominio)
https://app.ejemplo.com:8080/ruta -->  distinto (puerto)
CORS (Cross-Origin Resource Sharing) es el mecanismo que permite relajar la SOP de forma controlada. El servidor responde con cabeceras como Access-Control-Allow-Origin para indicar qué orígenes pueden leer sus respuestas.
Un CORS mal configurado es un hallazgo habitual. El caso más peligroso es:
Access-Control-Allow-Origin: https://atacante.com
Access-Control-Allow-Credentials: true
Esto permite que un sitio del atacante haga peticiones autenticadas al servidor vulnerable y lea las respuestas. Es como desactivar la SOP para ese atacante.
Content-Type y MIME sniffing#
La cabecera Content-Type le dice al navegador cómo interpretar el cuerpo de la respuesta. Si el servidor responde con Content-Type: text/html, el navegador renderiza HTML. Si responde con application/json, lo trata como datos.
El problema aparece cuando el servidor no pone Content-Type o pone uno genérico como application/octet-stream. Algunos navegadores (especialmente versiones antiguas de Internet Explorer) intentan adivinar el tipo real del contenido mirando los primeros bytes. Esto se llama MIME sniffing y puede convertir un archivo que el servidor quería servir como texto plano en HTML ejecutable si contiene etiquetas.
La defensa es la cabecera X-Content-Type-Options: nosniff, que le dice al navegador: «no adivines, respeta el Content-Type que te di».
Proxy inverso, proxy forward y CDN#
Proxy forward#
Es el proxy que configuras en tu navegador o en Burp Suite. El cliente sabe que existe y le envía las peticiones explícitamente. El proxy las reenvía al servidor de destino.
Proxy inverso#
Está delante del servidor, recibiendo las peticiones de los clientes sin que estos sepan que existe. Nginx, Apache (con mod_proxy), HAProxy y los balanceadores de carga son proxies inversos. Desde el punto de vista del pentester, el proxy inverso puede:
- Reescribir rutas y ocultar la estructura real del backend
- Añadir o eliminar cabeceras (como X-Forwarded-For)
- Cachear respuestas y servir contenido estático
- Aplicar reglas de WAF que bloquean payloads
Las discrepancias entre cómo interpreta una petición el proxy inverso y cómo la interpreta el backend son la raíz de los ataques de HTTP request smuggling.
CDN#
Una CDN (Content Delivery Network) como Cloudflare, Akamai o Fastly es un proxy inverso distribuido geográficamente. Cachea contenido estático y protege al servidor de origen. Para el pentester, la CDN puede ocultar la IP real del servidor. Herramientas como SecurityTrails, Censys o registros DNS históricos ayudan a descubrirla.
Un ataque relevante es el web cache poisoning: si logras que la CDN cachee una respuesta manipulada (por ejemplo, con una cabecera que inyecta contenido), todos los usuarios que reciban esa versión cacheada se ven afectados.
Cómo afecta todo esto al pentesting#
Cada concepto de esta lección se traduce en vectores de ataque concretos:
| Concepto | Vector de ataque |
|---|---|
| Métodos HTTP permisivos | PUT para subir webshells, DELETE para borrar recursos |
| Cookies sin HttpOnly | Robo de sesión via XSS |
| Cookies sin SameSite | CSRF contra acciones sensibles |
| CORS permisivo | Lectura cross-origin de datos autenticados |
| MIME sniffing | XSS al subir archivos con contenido HTML |
| Proxy inverso mal configurado | Request smuggling, bypass de WAF |
| Redirecciones no validadas | Open redirect para phishing |
| Códigos de error verbosos | Fuga de información (stack traces, rutas internas) |
Uso práctico paso a paso#
En el laboratorio doorkick, la primera fase requiere analizar las cabeceras HTTP:
# Reconocimiento de cabeceras de seguridad
curl -s -I http://IP_DEL_LAB/ | grep -iE "x-frame|content-security|strict-transport|x-content-type"
Para inspeccionar cookies:
# Ver las cookies que envía el servidor
curl -s -v http://IP_DEL_LAB/login 2>&1 | grep -i "set-cookie"
En un flujo completo con Burp Suite:
# Paso 1: Configurar Burp como proxy (127.0.0.1:8080)
# Paso 2: Navegar al sitio objetivo
# Paso 3: En la pestaña Proxy > HTTP history, examinar:
#   - Métodos usados (GET, POST, PUT, DELETE)
#   - Cabeceras de seguridad presentes y ausentes
#   - Cookies y sus atributos
#   - Respuestas con códigos 401, 403, 500
Para probar CORS:
# Enviar petición con origen arbitrario
curl -s -H "Origin: https://atacante.com" -I http://IP_DEL_LAB/api/datos | grep -i "access-control"
Si el servidor responde con Access-Control-Allow-Origin: https://atacante.com y Access-Control-Allow-Credentials: true, la configuración CORS es vulnerable.
Qué puede lograr un atacante#
| Escenario | Impacto |
|---|---|
| Cookie de sesión sin HttpOnly + XSS | Robo de sesión completa |
| CORS con origen comodín y credenciales | Lectura de datos privados desde sitio del atacante |
| PUT habilitado sin autenticación | Subida de webshell y ejecución de código |
| Request smuggling | Robo de peticiones de otros usuarios, bypass de controles |
| Open redirect en login | Robo de credenciales por phishing convincente |
| Cache poisoning en CDN | XSS persistente que afecta a todos los visitantes |
Buenas prácticas de seguridad#
Cabeceras de seguridad obligatorias#
Toda aplicación web debería incluir como mínimo:
Content-Security-Policy: default-src 'self'
Strict-Transport-Security: max-age=31536000; includeSubDomains
X-Content-Type-Options: nosniff
X-Frame-Options: DENY
Referrer-Policy: strict-origin-when-cross-origin
Cookies correctamente configuradas#
Set-Cookie: session=valor; HttpOnly; Secure; SameSite=Lax; Path=/; Max-Age=3600Nunca omitas HttpOnly ni Secure en cookies de sesión. Usa SameSite=Lax como mínimo.
CORS restrictivo#
Solo permite los orígenes que realmente necesitan acceso. Nunca reflejes el origen de la petición sin validarlo contra una lista blanca. Nunca combines Access-Control-Allow-Origin: * con Access-Control-Allow-Credentials: true (los navegadores lo bloquean, pero intentarlo indica que la lógica es frágil).
Deshabilitar métodos innecesarios#
Si la aplicación solo usa GET y POST, el servidor debería rechazar PUT, DELETE, TRACE y OPTIONS con un 405.
Errores comunes#
- No poner cabeceras de seguridad porque la aplicación funciona sin ellas. Funciona, pero queda expuesta a ataques que las cabeceras prevendrían.
- Confiar en que HTTPS protege contra todo. HTTPS protege el canal, no la lógica. Un IDOR funciona igual con o sin TLS.
- Configurar SameSite=None para que las cookies funcionen cross-site sin entender las implicaciones. Eso desactiva la protección contra CSRF.
- Usar CORS con origen comodín en APIs que manejan datos sensibles. El comodín es para recursos verdaderamente públicos, no para APIs autenticadas.
- No validar el Content-Type de los archivos subidos. Si el servidor sirve un archivo con Content-Type text/html, el navegador lo renderiza como HTML aunque sea un archivo subido por un usuario.
Preguntas frecuentes#
HTTP/2 cambia algo para el pentesting#
Sí. HTTP/2 usa un formato binario en lugar de texto plano, lo que cambia cómo se representan las peticiones internamente. Además, la multiplexación abre la puerta a variantes de request smuggling (H2.CL, H2.TE) que no existían en HTTP/1.1. Burp Suite las soporta, pero necesitas entender la diferencia.
SameSite=Lax es suficiente contra CSRF#
En la mayoría de los casos, sí. Lax permite enviar la cookie en navegaciones top-level con GET, pero la bloquea en peticiones POST cross-site y en peticiones embebidas (iframes, imágenes, fetch). Si tus acciones sensibles usan POST, Lax las protege. Para máxima protección, usa Strict, pero ten en cuenta que puede afectar la experiencia del usuario (por ejemplo, enlaces desde correos electrónicos no llevarán la sesión).
Qué es HTTP request smuggling#
Es un ataque que explota discrepancias entre cómo un proxy inverso y un servidor backend interpretan los límites de las peticiones HTTP. Si el proxy cree que una petición termina en un punto y el backend cree que termina en otro, el atacante puede inyectar una petición extra que el backend procesa como si fuera de otro usuario.
La CDN protege contra ataques web#
Parcialmente. Una CDN como Cloudflare incluye un WAF que bloquea payloads conocidos y protege contra DDoS. Pero no protege contra vulnerabilidades lógicas (IDOR, broken access control), configuraciones CORS inseguras o fallos en la gestión de sesiones. Además, si el atacante descubre la IP real del servidor, puede saltarse la CDN por completo.
Qué diferencia hay entre un proxy forward y un proxy inverso#
El proxy forward lo configura el cliente (como Burp Suite): el cliente sabe que existe y le envía las peticiones. El proxy inverso lo configura el servidor: los clientes no saben que existe, creen que hablan directamente con el servidor. En pentesting usas proxies forward para interceptar tráfico y te enfrentas a proxies inversos que protegen el backend.
Resumen#
- HTTP es sin estado: cada petición llega como si fuera la primera, lo que obliga a usar cookies o tokens para mantener sesiones.
- Las cookies de sesión necesitan HttpOnly, Secure y SameSite como mínimo. Sin ellos, XSS roba sesiones y CSRF ejecuta acciones en nombre del usuario.
- La Same-Origin Policy es la barrera fundamental del navegador; CORS la relaja de forma controlada, y un CORS mal configurado la anula.
- Los proxies inversos y CDN pueden ocultar el backend, pero también introducen vectores como request smuggling y cache poisoning.
- Entender HTTP es el prerrequisito para cualquier técnica de explotación web: sin él, los payloads son recetas copiadas sin contexto.