Análisis de logs: cómo detectar un ataque leyendo access.log, auth.log y journalctl
· 8 min de lectura
Aprende qué logs mira un analista de blue team ante un posible compromiso, qué patrones indican fuerza bruta, inyección SQL, XSS, shells y persistencia; cómo agregarlos y qué queries sacar.
Todo pentester acaba descubriendo, tarde o temprano, que el mejor camino para mejorar sus ataques es leer los logs que un ataque deja. Y al revés: todo defensor que quiera adelantarse a un incidente tiene que aprender a interpretar esos mismos logs a velocidad, identificando patrones de ataque conocidos entre miles de líneas normales de operación diaria.
Esta lección no es sobre SIEMs comerciales ni sobre arquitecturas EDR. Es sobre lo esencial: qué archivos miras en un servidor Linux cuando sospechas un compromiso, qué patrones gritan «ataque», qué queries lanzas sobre un ELK o un Loki, y cómo distinguir ruido normal de actividad real. Lo probarás en el laboratorio snort de whoami-labs, que te entrega capturas reales de tráfico y logs para que practiques detección.
Esta lección cubre defensa. Las técnicas de análisis que aprendes también sirven para entender mejor cómo te ven cuando atacas, pero el foco es cómo un defensor recupera el control.
Las fuentes#
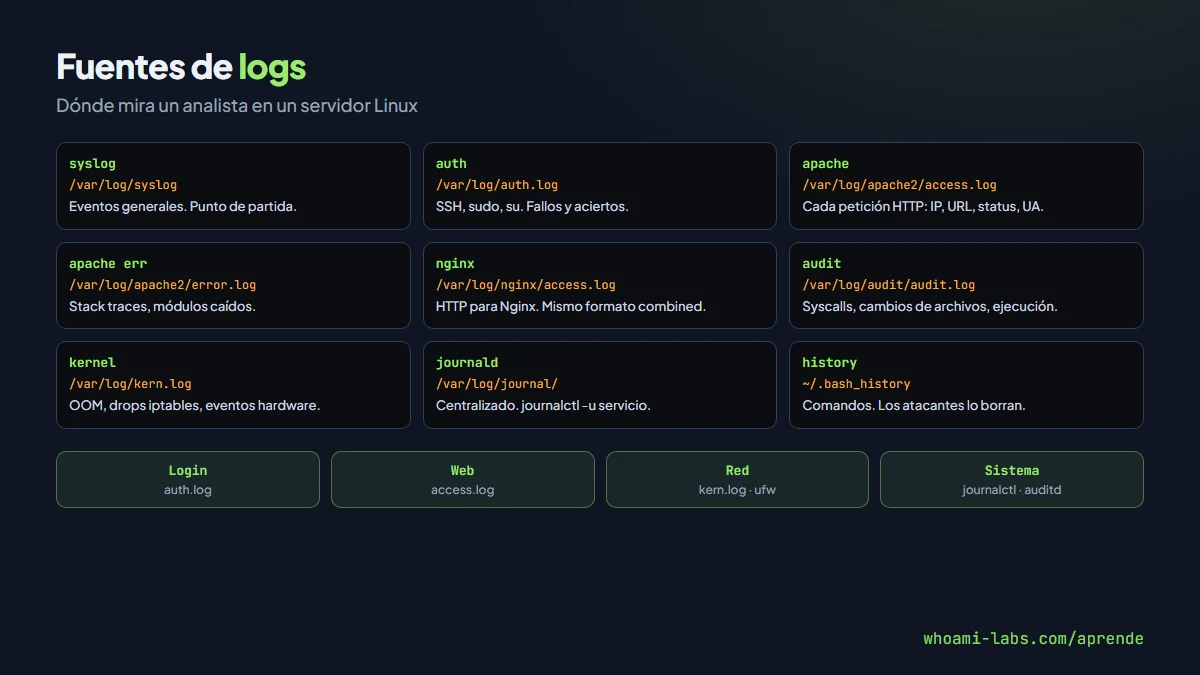
En un servidor Linux moderno, los archivos clave están aquí:
| Archivo | Qué contiene |
|---|---|
/var/log/syslog o /var/log/messages | Eventos generales del sistema |
/var/log/auth.log o /var/log/secure | Logins (SSH, sudo, su) |
/var/log/apache2/access.log | Peticiones HTTP |
/var/log/apache2/error.log | Errores del servidor web |
/var/log/nginx/access.log | Peticiones HTTP (Nginx) |
/var/log/audit/audit.log | Auditd: syscalls, archivos modificados |
/var/log/kern.log | Kernel (OOM, drops iptables) |
/var/log/journal/ | Journald: todo centralizado |
~/.bash_history | Historial de comandos (atacantes lo borran) |
Para Windows: Event Viewer (Security, System, Application, Sysmon), PowerShell operational log, firewall log. Para contenedores: docker logs, /var/log/containers/ en Kubernetes.
Fuerza bruta SSH#
Patrón más fácil de detectar. El típico auth.log:
Nov  5 10:23:14 host sshd[1234]: Failed password for root from 185.42.11.3 port 51231 ssh2
Nov  5 10:23:16 host sshd[1234]: Failed password for root from 185.42.11.3 port 51231 ssh2
Nov  5 10:23:17 host sshd[1234]: Failed password for admin from 185.42.11.3 port 51231 ssh2
Nov  5 10:23:19 host sshd[1234]: Failed password for test from 185.42.11.3 port 51231 ssh2
Query útil:
# Top IPs con más fallos de login en la última semana
grep "Failed password" /var/log/auth.log | \
  awk '{print $(NF-3)}' | sort | uniq -c | sort -rn | head
Un pico de miles de intentos desde una IP = brute force confirmada. Siguiente paso: fail2ban-client status sshd o iptables -L INPUT para ver si ya está bloqueada; si no, bloqueo manual y ampliación de reglas.
Fuerza bruta web#
En access.log:
# Muchos 401/403 desde la misma IP en poco tiempo → brute force login web
awk '$9 == 401 || $9 == 403 {print $1}' access.log | \
  sort | uniq -c | sort -rn | head

# POST repetidos a /wp-login.php o /admin/
grep "POST /wp-login.php" access.log | awk '{print $1}' | sort | uniq -c | sort -rn
Para WordPress, también XML-RPC multicall:
grep "POST /xmlrpc.php" access.log | awk '{print $1}' | sort | uniq -c | sort -rnUn solo host con cientos de POST a /xmlrpc.php en minutos = brute force amplificado.
SQL injection#
En access.log, buscar patrones típicos de payloads SQLi:
grep -iE "(UNION.*SELECT|SELECT.*FROM.*information_schema|OR.*1=1|'.*OR.*'|SLEEP\()" access.logCasi todos los WAF modernos tienen reglas para esto y lo marcan. Si tu servidor no tiene WAF, el access.log sigue siendo la fuente para investigar.
XSS#
Buscar scripts reflected en query strings:
grep -iE "(<script|%3Cscript|onerror=|javascript:|alert\()" access.logÚtil para forense y para confirmar si un payload llegó (el 200 o 400 te lo dice, el tamaño de respuesta te dice si se reflectó).
Web shells y comandos remotos#
Si sospechas que hay una shell en el servidor:
# Archivos PHP creados recientemente en directorios de subida
find /var/www -name "*.php" -mtime -7 -ls

# Archivos con eval, base64_decode, assert, system en el código
grep -rE "(eval\(|base64_decode\(|assert\(|system\(|passthru\(|shell_exec\()" /var/www/

# Procesos extraños corriendo como www-data
ps aux | grep www-data | grep -vE "apache2|nginx|php-fpm"
Una shell suele dejar archivo nuevo en uploads/, images/, tmp/ con nombre críptico (a1b2.php, abc.php), tamaño pequeño y modificación reciente.
Persistencia: cronjobs, servicios, autoruns#
Los atacantes dejan mecanismos de persistencia. Dónde mirar:
# Cron de todos los usuarios
for u in $(cut -d: -f1 /etc/passwd); do
  echo "=== $u ==="
  crontab -l -u "$u" 2>/dev/null
done
ls -la /etc/cron.d/ /etc/cron.hourly/ /etc/cron.daily/ /etc/cron.weekly/

# Servicios custom
systemctl list-unit-files --state=enabled | grep -vE "^(systemd-|getty|user@|sshd|cron|rsyslog)"

# Autoruns root
cat /root/.bash_profile /root/.bashrc /root/.profile 2>/dev/null

# ~/.ssh/authorized_keys sospechosas
find /home -name "authorized_keys" -exec ls -la {} \;
Si encuentras cronjobs que no reconoces, servicios con nombres aleatorios o claves SSH extra en usuarios que no deberían tenerlas, hay persistencia.
Correlación: timeline de un incidente#
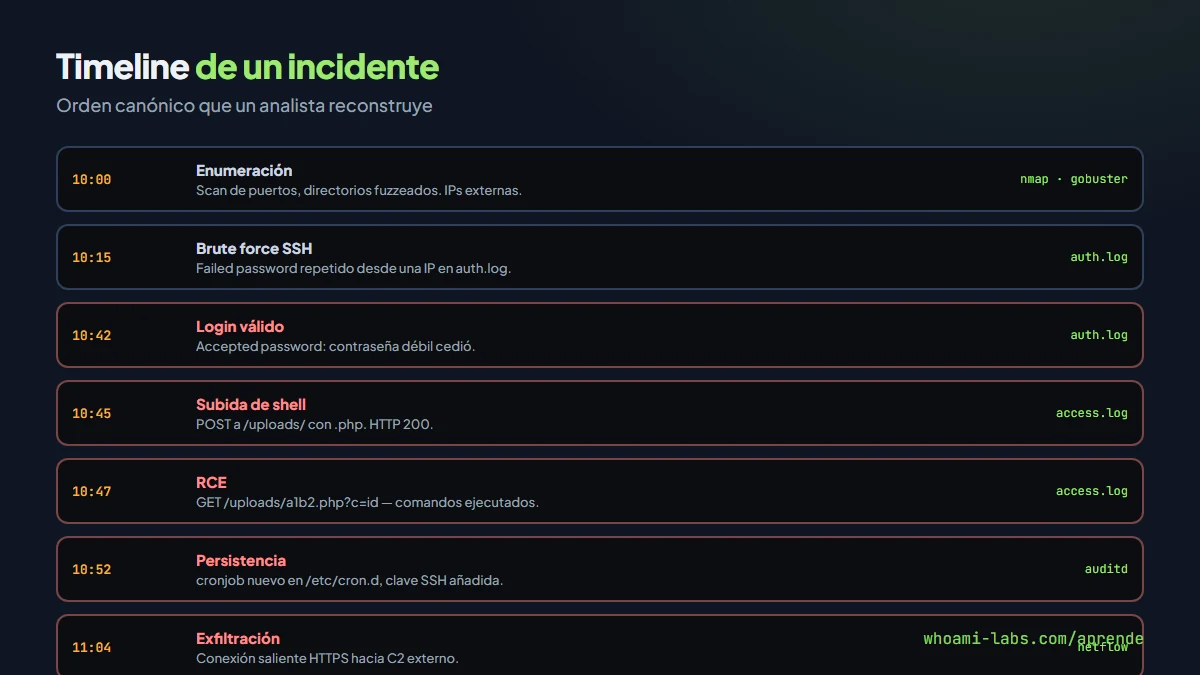
Para armar el timeline de un incidente, cruza las fuentes:
Paso 1: encuentra la primera señal (alerta WAF, antivirus, login extraño).
Paso 2: busca peticiones de esa IP en access.log antes de la alerta. ¿Enumeración? ¿Brute force?
Paso 3: identifica si llegó a entrar: líneas Accepted password en auth.log o 200 /wp-login.php con redirect correcto en access.log.
Paso 4: traza qué hizo después: subidas, comandos, procesos nuevos.
Paso 5: identifica persistencia (cron, servicios, claves SSH).
Paso 6: revisa logs de salida (iptables -L -n -v, netstat, ss -tunlp) por conexiones establecidas.
Con todos los pasos documentados, tienes el timeline del incidente para el informe post-mortem.
Agregación: cuando un servidor no basta#
En infraestructura real, los logs se centralizan. Herramientas comunes:
- ELK Stack (Elasticsearch, Logstash, Kibana): open source, flexible, exigente en recursos.
- Grafana Loki: más ligero, más barato, integrado con Prometheus/Grafana.
- Graylog: alternativa con buen UX.
- Wazuh: open source orientado a seguridad, con reglas pre-escritas.
- Splunk: comercial, estándar de facto en empresas grandes.
- Chronicle, Elastic Security, Microsoft Sentinel: SIEMs cloud.
Para labs y entornos pequeños, Loki + Promtail + Grafana es imbatible por relación potencia/coste. Para producción corporativa, Splunk o un SIEM gestionado si el presupuesto lo permite.
Queries útiles en Loki/LogQL#
# Fallos de login SSH por IP en las últimas 24h
{job="ssh"} |= "Failed password" | regexp "from (?P<ip>\\S+) port" | count_over_time([1h]) by (ip)

# Códigos 500 en Apache
{job="apache"} | logfmt | status=500

# Peticiones POST a wp-login.php
{job="apache"} |~ "POST /wp-login.php"
Reglas Sigma: patrones universales#
Para no escribir detecciones distintas por cada SIEM, la comunidad ha estandarizado el formato Sigma: reglas en YAML que luego se traducen a queries de ELK, Splunk, Loki, Chronicle. Un ejemplo:
title: SSH brute force intento
logsource:
  product: linux
  service: sshd
detection:
  selection:
    message|contains: "Failed password"
  timeframe: 5m
  condition: selection | count() by src_ip > 10
level: medium
El repositorio público SigmaHQ mantiene cientos de reglas para fuerza bruta, movimiento lateral, ejecución sospechosa, persistencia, exfiltración. Importarlas al SIEM da cobertura inmediata de los patrones más comunes. Un equipo defensivo serio empieza siempre por adoptar Sigma antes de inventar reglas propias.
Herramientas útiles de consola#
Algunas herramientas que todo analista tiene a mano:
# goaccess: dashboard en terminal para access.log
goaccess /var/log/apache2/access.log -c

# lnav: navegador de logs con syntax highlighting
lnav /var/log/

# jq para JSON logs
tail -f /var/log/app.json | jq 'select(.level == "error")'

# logwatch: reportes diarios
logwatch --detail high --output stdout

# chkrootkit, rkhunter: buscar rootkits conocidos
chkrootkit -q
rkhunter --check --rwo
goaccess es particularmente útil para ver, en tiempo real, qué pasa en el access.log sin montar un dashboard completo. Para labs y respuesta rápida a incidentes, es imbatible.
Un ejemplo guiado: investigando un 500#
Supón que recibes la alerta: aumento de errores 500 en producción. Los pasos clásicos:
Paso 1 — contar y correlacionar:
# ¿Cuántos por minuto en las últimas horas?
awk '$9 == 500 {print substr($4,2,17)}' access.log | sort | uniq -c
Paso 2 — ver qué URLs:
awk '$9 == 500 {print $7}' access.log | sort | uniq -c | sort -rn | headPaso 3 — ver qué IPs los piden:
awk '$9 == 500 {print $1}' access.log | sort | uniq -c | sort -rn | headPaso 4 — correlacionar con error.log:
# Timestamp del primer 500, buscar en error.log
grep "2026-11-05 10:" /var/log/apache2/error.log | head -20
Paso 5 — decidir: ¿bug de código tras un deploy? ¿ataque con payload que rompe parseo? ¿capacidad agotada? El error.log suele revelarlo.
Este bucle —contar, agrupar, cruzar con otra fuente, interpretar— es la mecánica básica del análisis defensivo.
Errores comunes del defensor#
- Dejar los logs solo en el host comprometido (el atacante los borra primero).
- No rotar ni cerrar permisos: cualquier usuario puede leer
auth.log. - Buscar solo lo evidente: patrones conocidos. Los ataques modernos ofuscan.
- Fiarse solo del WAF sin mirar los logs reales.
- No tener timeline sincronizado (NTP) entre servidores.
- Olvidar los logs de la aplicación: muchas veces loguean más que syslog.
Errores comunes del atacante (y qué revelan al defensor)#
- No borrar
~/.bash_historytras acabar. - Dejar binarios con nombre genérico en
/tmpo/dev/shm. - Usar un User-Agent estático (
curl/7.68.0) para cientos de requests. - Timestamps exactos en secuencia: un script en bucle deja un patrón perfectamente periódico.
- Reutilizar las mismas 3-4 IPs: fáciles de bloquear.
Un buen analista de logs identifica esos patrones en minutos.
Preguntas frecuentes#
¿Qué hago primero si creo que hay intrusión?#
Aislar el host (red cortada, procesos congelados si es posible), copiar los logs a otro servidor antes de reiniciar, snapshot de memoria si se puede. Luego analizar. Reiniciar borra evidencia.
¿Debería usar grep o jq para logs JSON?#
Para logs JSON (muchos servicios modernos escriben JSON), jq es imprescindible. grep sigue funcionando pero pierde estructura.
¿Cuánto tiempo retengo logs?#
Depende del compliance. GDPR, PCI-DSS, SOX tienen requisitos específicos. Como mínimo 30 días para operación; 1 año o más para incidentes y auditorías.
¿Los atacantes modernos saben cómo borrar logs?#
Los sofisticados sí. Los que automatizan masivamente, no. En un ataque targetado profesional, los logs locales no son suficiente; necesitas agregación externa en tiempo real.
¿Dónde practico?#
En el laboratorio snort de whoami-labs, que te entrega una captura real de ataque: tienes que identificar el vector, el timeline y la persistencia dejada.
¿Un servidor Windows cambia mucho?#
El concepto es el mismo, cambian las fuentes. En Windows mirarías Event Viewer (Security IDs 4624 para login exitoso, 4625 para fallido, 4688 para creación de proceso), PowerShell operational log, Sysmon (muy recomendado: añade telemetría de procesos, red, archivos), y Windows Defender logs si está activo. La mecánica —contar, agrupar, cruzar— es idéntica.
¿Qué pasa con contenedores Docker/Kubernetes?#
Los logs van a stdout/stderr del contenedor por diseño. docker logs <id> o kubectl logs <pod> los extraen. En clusters serios se envían a Loki, Fluentd o Elastic desde el kubelet. La investigación forense sobre contenedores efímeros es más compleja: si el pod murió, perdiste los logs locales; por eso la agregación externa es aún más crítica que en servidores tradicionales.
Resumen#
- Los logs del sistema son la primera y mejor fuente para detectar un ataque.
- Patrones clave: fallos de login repetidos, payloads SQLi/XSS, archivos nuevos en uploads, cronjobs y claves SSH extrañas.
- Para correlacionar, timeline cruzando
auth.log,access.log, aplicación y procesos. - Agregación en ELK, Loki, Wazuh, Splunk para infraestructura real.
- Los logs locales se borran: centralizar en tiempo real es la única defensa seria.